


Maschinelles Lernen leicht gemacht!
Beginnen Sie noch heute mit dem Training Ihrer eigenen Machine-Learning-Modelle. Sie können asanAI in jedem beliebigen Browser verwenden – und die Nutzung ist völlig kostenlos!
Mehr erfahrenBeginnen Sie noch heute mit dem Training Ihrer eigenen Machine-Learning-Modelle. Sie können asanAI in jedem beliebigen Browser verwenden – und die Nutzung ist völlig kostenlos!
Mehr erfahrenDie Approximation einfacher Funktionen mit asanAI ist sehr einfach. Auf dieser Seite zeigen wir Ihnen, wie die Approximation einfacher Funktionen funktioniert und wie Sie sie selbst durchführen können. Nehmen wir zum Beispiel die folgenden Daten:
x1,x2,y1,y2
5, 1, 6, 12
10, 2, 12, 24
15, 3, 18, 36
20, 4, 24, 48
25, 5, 30, 60
30, 6, 36, 72
35, 7, 42, 84
40, 8, 48, 96
45, 9, 54, 108
50, 10, 60, 120
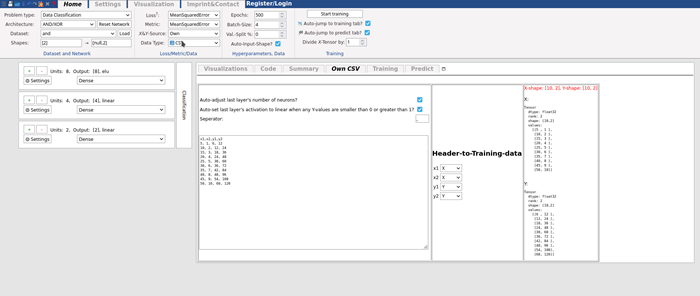
Wir haben keine Ahnung, um welche Funktion es sich bei den Daten handeln könnte. Für dieses Beispiel haben wir „Problemtyp“ -> „Datenklassifizierung“ ausgewählt. Wir erhalten ein Standardnetzwerk mit den Schichten und jeweils 3, 4 und 1 Neuronen. Wir haben „X&Y-Daten“ -> „own“ und anschließend „Datentyp“ -> „CSV“ ausgewählt. Anschließend haben wir sowohl y1 als auch y2 als Y ausgewählt.
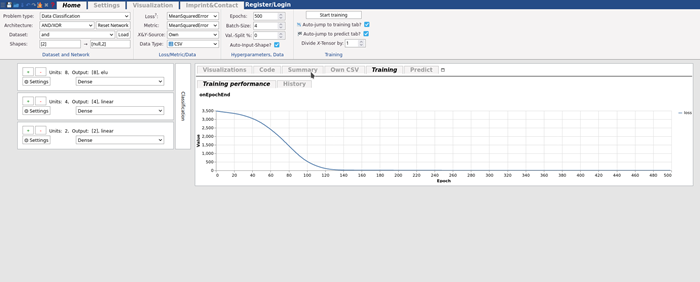
Nun können wir den Verlust Mean Squared Error verwenden. Dieser bewertet Fehler strenger als der MAE und eignet sich gut für diese Art von Daten. Anschließend klicken wir auf Start Training. In der Grafik ist zu sehen, dass der Trainingsverlust abnimmt. Nach 500 Epochen – der Standardeinstellung – liegt er bei etwa 0,004, was für die meisten Anwendungsfälle ausreichend ist. Wir hätten das Training auch früher beenden können, um Zeit zu sparen, als der Rückgang deutlich nachließ.
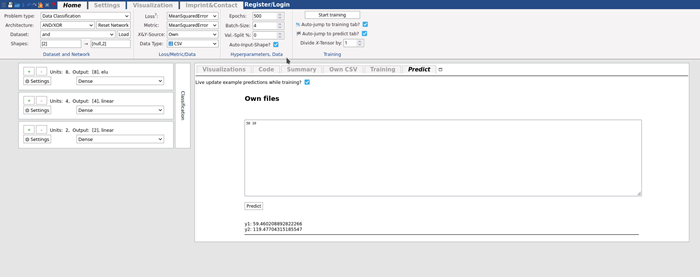
Auf der Registerkarte predict können Sie Beispieldaten eingeben. Wir wissen, dass [50 10] das Ergebnis [60, 120] liefern sollte. Wir können „10 50“ eingeben, um zu sehen, welches Ergebnis das Netzwerk dafür liefert:
y1: 59.460208892822266
y2: 119.47704315185547
Das kommt dem, was es sein sollte, sehr nahe. Wir können nun Daten eingeben, die ihm bisher unbekannt waren, wie beispielsweise [60, 20]. Die dem Modell zugrunde liegenden Gleichungen liefern uns die Ergebnisse [80, 160]. Das Netzwerk liefert uns:
y1: 82.96539306640625
y2: 157.47305297851562
Das entspricht fast genau den tatsächlichen Werten. Denken Sie daran: Das Netzwerk hat diese Daten noch nie gesehen, sagt sie aber dennoch sehr genau voraus. Wenn das Ergebnis stark abweicht, ist das Netzwerk möglicherweise nicht komplex genug, um diese Funktion zu approximieren. Sie können dem Netzwerk weitere Schichten hinzufügen, damit es komplexere Muster erkennen kann.



Copyright 2026 © SCADS.AI Dresden/Leipzig – All rights reserved.
Sie müssen den Inhalt von reCAPTCHA laden, um das Formular abzuschicken. Bitte beachten Sie, dass dabei Daten mit Drittanbietern ausgetauscht werden.
Mehr InformationenSie sehen gerade einen Platzhalterinhalt von Turnstile. Um auf den eigentlichen Inhalt zuzugreifen, klicken Sie auf die Schaltfläche unten. Bitte beachten Sie, dass dabei Daten an Drittanbieter weitergegeben werden.
Mehr InformationenSie sehen gerade einen Platzhalterinhalt von Facebook. Um auf den eigentlichen Inhalt zuzugreifen, klicken Sie auf die Schaltfläche unten. Bitte beachten Sie, dass dabei Daten an Drittanbieter weitergegeben werden.
Mehr InformationenSie sehen gerade einen Platzhalterinhalt von Instagram. Um auf den eigentlichen Inhalt zuzugreifen, klicken Sie auf die Schaltfläche unten. Bitte beachten Sie, dass dabei Daten an Drittanbieter weitergegeben werden.
Mehr InformationenSie sehen gerade einen Platzhalterinhalt von X. Um auf den eigentlichen Inhalt zuzugreifen, klicken Sie auf die Schaltfläche unten. Bitte beachten Sie, dass dabei Daten an Drittanbieter weitergegeben werden.
Mehr Informationen