


Maschinelles Lernen leicht gemacht!
Beginnen Sie noch heute mit dem Training Ihrer eigenen Machine-Learning-Modelle. Sie können asanAI in jedem beliebigen Browser verwenden – und die Nutzung ist völlig kostenlos!
Mehr erfahrenBeginnen Sie noch heute mit dem Training Ihrer eigenen Machine-Learning-Modelle. Sie können asanAI in jedem beliebigen Browser verwenden – und die Nutzung ist völlig kostenlos!
Mehr erfahrenDiese Seite bietet einen umfassenden Überblick über die theoretischen Grundlagen von asanAI.
Wenn wir über Daten sprechen, sind drei grundlegende Begriffe besonders wichtig: Vektoren, Matrizen und Tensoren. Glücklicherweise sind sie nicht so kompliziert, wie sie scheinen. Ein Vektor ist einfach eine geordnete Folge von Zahlen, wie zum Beispiel [1, 2, 3]. Dieser Vektor hat eine Länge von 3. Diese Zahlen können beliebige Werte annehmen – es können Entfernungen, Preise, Messwerte und so weiter sein. Nimmt man viele Vektoren, kann man daraus eine Matrix bilden. Wenn wir vereinbaren, dass 1 für Weiß und 0 für Schwarz steht, ergibt sich daraus das Bild des Buchstabens L. Farbbilder bestehen beispielsweise aus drei solchen Matrizen, eine für Rot, eine für Grün und eine für Blau. Sie können sich diese als Untermatrizen einer größeren Matrix vorstellen.
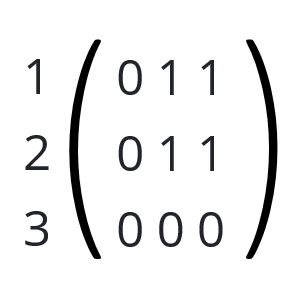
Dies ist ein sogenannter Tensor. Ein Tensor ist eine Matrix, die andere Matrizen enthält. Die R-, G- und B-Matrizen haben dieselbe Form: 2 Werte in der Breite und 4 Werte in der Höhe. Dies wird als [2, 4] ausgedrückt. Die Matrix um R, G und B ist 3 Werte breit (jeder Wert ist eine Matrix) und 1 px hoch. Der gesamte Tensor hat somit die Form [2, 4, 3]. Diese Tensoren können beliebige Formen und Längen haben. Sie können alle Arten von Daten darstellen, egal ob es sich um Bilder, Töne, Videos, Messdaten oder sonst etwas handelt. Wenn Sie es auf irgendeine Weise in einen Computer einspeisen können, lässt es sich als solcher Tensor darstellen.
Um einen grundlegenden Überblick darüber zu erhalten, was ein neuronales Netzwerk ist, müssen wir uns zunächst mit Funktionen befassen. Eine Funktion f(x) nimmt eine Eingabe entgegen, führt eine Verarbeitung daran durch und gibt das Ergebnis anschließend wieder aus.
Wenn wir x = 5 setzen, erhalten wir: 2 * 5 + 1 = 11. Bei neuronalen Netzen verhält es sich ähnlich, nur umgekehrt. Wir haben nicht die Regel für die Funktion, sondern ihre Ein- und Ausgänge. Beispielsweise könnten wir eine Liste wie die folgende haben:
x, y
1, 3
2, 5
3, 7
4, 9
5, 11
6, 13
7, 15
8, 17
9, 19
10, 21
Nun geben wir dem Computer folgende Anweisung: Dies ist ein Beispiel für die Eingabe- und Ausgabewerte einer Funktion f(x) = y. Bitte finde eine Funktion, die diese Werte annähernd wiedergibt. Beachte, dass X und Y nicht nur Zahlen sein können, sondern ganze Tensoren mit beliebig vielen Dimensionen – dazu gehören auch Bilder, Videos, komplexe Messdaten aus der Wissenschaft und so weiter.
Einer der Grundideen ist das Neuron.
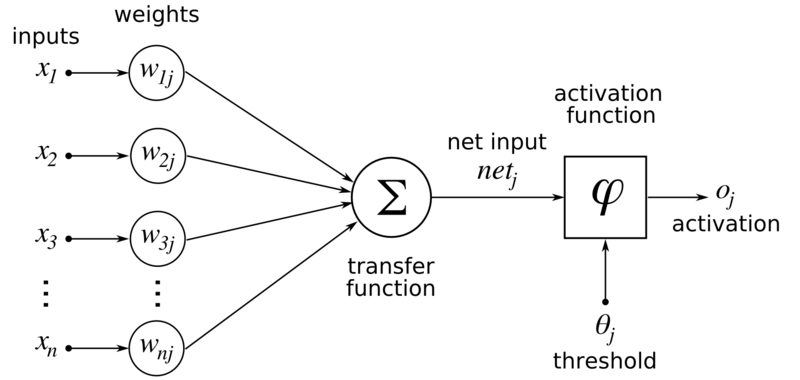
Ein Neuron verfügt über viele Eingänge. Jeder Eingang kann eine Zahl sein (oder in komplexeren Fällen ein Tensor). Jeder dieser Eingänge hat ein sogenanntes Gewicht. Beträgt das Gewicht 0,5 und die Eingangszahl 2, wertet das Neuron diesen Eingang als 0,5 * 2 = 1 aus. Wir können dann noch einen Bias hinzufügen, bei dem es sich lediglich um eine Zahl handelt, die nach der Summierung aller gewichteten Eingänge addiert wird.
Das Neuron summiert einfach alle diese Eingaben. Diese Summe wird dann an eine Aktivierungsfunktion weitergeleitet. Die Funktion verarbeitet den Wert, beispielsweise indem sie ihn auf einen Bereich zwischen 0 und 1 drückt (wobei hohe Werte näher an 1 liegen als niedrige). Dies geschieht, um Nichtlinearität im Netzwerk zu erzielen, sodass es komplexere Muster als nur lineare erkennen kann.
Wenn wir über mehrere Neuronen verfügen, können wir diese in Schichten gruppieren. Die Schichten, die ausschließlich aus solchen Neuronen bestehen, werden als „Dense Layers“ (dichte Schichten) bezeichnet. Eine Schicht besteht aus einem oder mehreren Neuronen. Innerhalb der Schichten verbinden wir diese Neuronen nicht miteinander. Zwischen den Schichten verbinden wir jedoch jedes Neuron mit einem Neuron in der vorherigen bzw. nächsten Schicht. Die Ausgabe der letzten Schicht enthält die Ergebnisse unseres Netzwerks.
Eine lineare Funktion, zum Beispiel f(x) = 2x, benötigt keine Aktivierungsfunktion, um sie durch eine nichtlineare Funktion zu approximieren. Eine nichtlineare Funktion, zum Beispiel f(x) = tan(x) / sin(x), benötigt jedoch eine solche. Frage zur Entscheidung, ob Sie eine Aktivierungsfunktion benötigen: Kann eine einzelne Gerade meinen Datensatz genau darstellen oder ihn in Kategorien unterteilen? Wenn ja, kann die Aktivierungsfunktion „linear“ sein (entspricht keiner Aktivierungsfunktion), andernfalls benötigen Sie eine Aktivierungsfunktion. Ein weiterer Anwendungsfall für eine lineare Aktivierung wäre, wenn Sie diskrete, große Ausgabewerte wie 19 anstelle von Werten zwischen 0 und 1 wünschen. In diesem Fall benötigen Sie möglicherweise eine lineare Aktivierung in der letzten Schicht.
Manche Aktivierungsfunktionen sind stärker spezialisiert als andere. Softmax summiert beispielsweise alle Werte, die ihm zugeführt werden, und gibt dann einen Prozentsatz zurück, der angibt, wie viel diese einzelnen Werte vom Gesamtwert ausmachen.
SoftMax([1, 2, 5]) = [0.125, 0.25, 0.625].
Die Ausgabe von Softmax ergibt immer die Summe von 1 (= 100%).
Im Hintergrund handelt es sich dabei größtenteils nur um Matrix- (oder Tensor-)Multiplikation und -Addition. Das Ergebnis ist dann ein weiterer Tensor (der auch ein Vektor oder einfach eine einzelne Zahl sein kann). Auf diese Weise ist das gesamte neuronale Netzwerk eine Funktion.
Der Computer erhält eine Liste von Werten, die als Trainingsdaten bezeichnet werden, damit er weiß, wie sich die Funktion verhalten soll. Er nimmt einige dieser Werte (einen „Batch“) und gibt sie in die neuronale Netzwerkfunktion ein, um zu sehen, was dabei herauskommt. Die erwartete Ausgabe ist bekannt. Anschließend betrachtet der Trainingsalgorithmus die Differenz zwischen den Ausgaben. Diese wird als Verlust bezeichnet. Ein Beispiel für einen Verlust wäre die mittlere absolute Differenz (MAD). Wenn der Ausgabevektor [1, 2, 3] lauten sollte, die Funktion jedoch [2, 2,1, 4] liefert, betragen die Differenzen [1, 0,1, 1], sodass der Mittelwert davon (1 + 0,1 + 1)/3 = 0,7 ist. Der Verlust (MAE) beträgt also 0,7. Die Gewichte und Offsets der Funktion werden anschließend korrigiert, sodass der Verlust im Laufe der Zeit abnimmt.
In classical algorithms, we have certainty of their results. If you implement it properly and the algorithm works, you always get correct results. But in neural networks, trade certainty for the ability to solve problems that we cannot solve otherwise. Neural networks rarely give exact results, but just good-enough approximations.
After training the network, you can predict new values. Predict means: get the outputs of the function with the potentially never seen input values. Imagine it on images: you’ve trained the network on 1000 images of dogs and 1000 images of cats to classify images into those 2 categories. If you give it an image it has never seen before (that was not in the training data) it should still be able to classify it correctly, even though the network has never seen the new data before.
Bei klassischen Algorithmen haben wir Gewissheit über ihre Ergebnisse. Wenn sie richtig implementiert werden und der Algorithmus funktioniert, erhält man immer korrekte Ergebnisse. Bei neuronalen Netzen wird jedoch diese Gewissheit gegen die Fähigkeit eingetauscht, Probleme zu lösen, die wir auf andere Weise nicht lösen können. Neuronale Netze liefern selten exakte Ergebnisse, sondern lediglich ausreichend gute Näherungswerte.
Nach dem Training des Netzes können Sie neue Werte vorhersagen. Vorhersagen bedeutet: die Ausgabewerte der Funktion für möglicherweise noch nie gesehene Eingabewerte zu ermitteln. Stellen Sie sich das anhand von Bildern vor: Sie haben das Netzwerk mit 1.000 Bildern von Hunden und 1.000 Bildern von Katzen trainiert, um Bilder in diese beiden Kategorien einzuordnen. Wenn Sie ihm ein Bild geben, das es noch nie gesehen hat (das nicht in den Trainingsdaten enthalten war), sollte es dennoch in der Lage sein, dieses korrekt zu klassifizieren, obwohl das Netzwerk die neuen Daten noch nie zuvor gesehen hat.



Copyright 2026 © SCADS.AI Dresden/Leipzig – All rights reserved.
Sie müssen den Inhalt von reCAPTCHA laden, um das Formular abzuschicken. Bitte beachten Sie, dass dabei Daten mit Drittanbietern ausgetauscht werden.
Mehr InformationenSie sehen gerade einen Platzhalterinhalt von Turnstile. Um auf den eigentlichen Inhalt zuzugreifen, klicken Sie auf die Schaltfläche unten. Bitte beachten Sie, dass dabei Daten an Drittanbieter weitergegeben werden.
Mehr InformationenSie sehen gerade einen Platzhalterinhalt von Facebook. Um auf den eigentlichen Inhalt zuzugreifen, klicken Sie auf die Schaltfläche unten. Bitte beachten Sie, dass dabei Daten an Drittanbieter weitergegeben werden.
Mehr InformationenSie sehen gerade einen Platzhalterinhalt von Instagram. Um auf den eigentlichen Inhalt zuzugreifen, klicken Sie auf die Schaltfläche unten. Bitte beachten Sie, dass dabei Daten an Drittanbieter weitergegeben werden.
Mehr InformationenSie sehen gerade einen Platzhalterinhalt von X. Um auf den eigentlichen Inhalt zuzugreifen, klicken Sie auf die Schaltfläche unten. Bitte beachten Sie, dass dabei Daten an Drittanbieter weitergegeben werden.
Mehr Informationen