
Machine Learning zur Erkennung von Molekülen, Metaboliten und chemischen Reaktionen
Projekttitel: Machine Learning zur Erkennung von Molekülen, Metaboliten und chemischen Reaktionen
Projektlaufzeit: 3 Jahre
Forschungsbereich: Mathematical Foundations: Discrete Mathematics and Cheminformatics
Wenn Machine-Learning-Methoden eingesetzt werden, um molekulare Kandidaten in Bereichen wie der Wirkstoffentwicklung (Drug Discovery) zu erzeugen, können diese routinemäßig unrealistische Moleküle als Vorschläge zurückmelden. Wir sehen dies im Zusammenhang mit einem fundamentalen theoretischen Problem, speziell der Frage, wie bestimmt werden kann, ob ein beliebiger molekularer Kandidat-Graph tatsächlich ein reales Molekül modellieren kann oder ob dies mathematisch unmöglich ist. Angesichts der Komplexität des derzeit bekannten chemischen Universums lässt sich erkennen, dass dies kein einfaches statistisches Problem ist und den Einsatz von Machine-Learning-Techniken erfordert. Hier schlagen wir die Verwendung der als Double-Pushout-Ansatz bekannten Graphtransformationsmethode vor, die als Grundlage für ein solches Klassifikationssystem dienen soll. Wir untersuchen ihre Anwendungen als neuartigen Ansatz für die in-silico-Konstruktion und Erkundung chemischer Räume.
Ziele
Wir entwerfen unsere Machine-Learning-Algorithmen im Paradigma der Explainable Artificial Intelligence (erklärbaren Künstlichen Intelligenz) mit dem Ziel, dass diese in der Lage sind, die aus den Daten gelernten Aspekte auf explizite, für Menschen verständliche Weise zurückzumelden. Wir streben eine integrierte Studie zur vielversprechenden Leistungsfähigkeit des Double-Pushout-Ansatzes und der Explainable-Machine-Learning-Methoden an.
Problemstellung
Zwei Felder mit wichtigen biochemischen Anwendungen sind die retrosynthetische Analyse und die Wirkstoffentwicklung. Beide Bereiche haben in jüngster Zeit von der Einbindung von Machine-Learning-Algorithmen in ihre Werkzeuge für die in-silico-Analyse profitiert. Eine Gemeinsamkeit der meisten dieser Machine-Learning-Verbesserungen ist, dass sie Graphentheorie nutzen, um computergestützte Repräsentationen der von ihnen erzeugten Kandidatenmoleküle zu erstellen, die prinzipiell keine realen Moleküle abbilden müssen.
Um diese Kandidaten zu erhalten, stützen sich diese Methoden auf das Training über Mengen realer Moleküle, die aus Datenbanken abgerufen werden, wobei sie allein von diesem Aspekt erwarten, dass er die Tragfähigkeit ihrer Vorschläge sicherstellt. Dabei ignorieren sie jedoch eines von mehreren fundamentalen Problemen, die wir adressieren möchten, nämlich die Frage, wie bestimmt werden kann, ob ein beliebiger chemischer Graph tatsächlich synthetisiert werden kann oder ob er nur ein undurchführbarer abstrakter Konstrukt sein kann. Wir sind der Ansicht, dass im Kern dieses Problems die kombinatorischen Einschränkungen liegen, die die Chemie natürlicherweise für die Kandidatengraphen auferlegt.
Praxisbeispiel
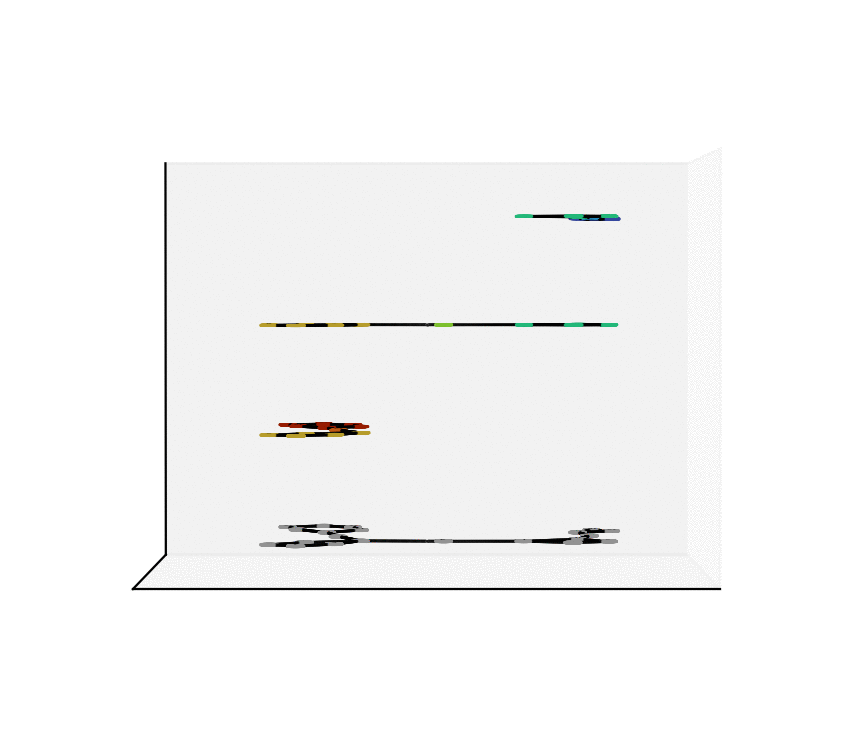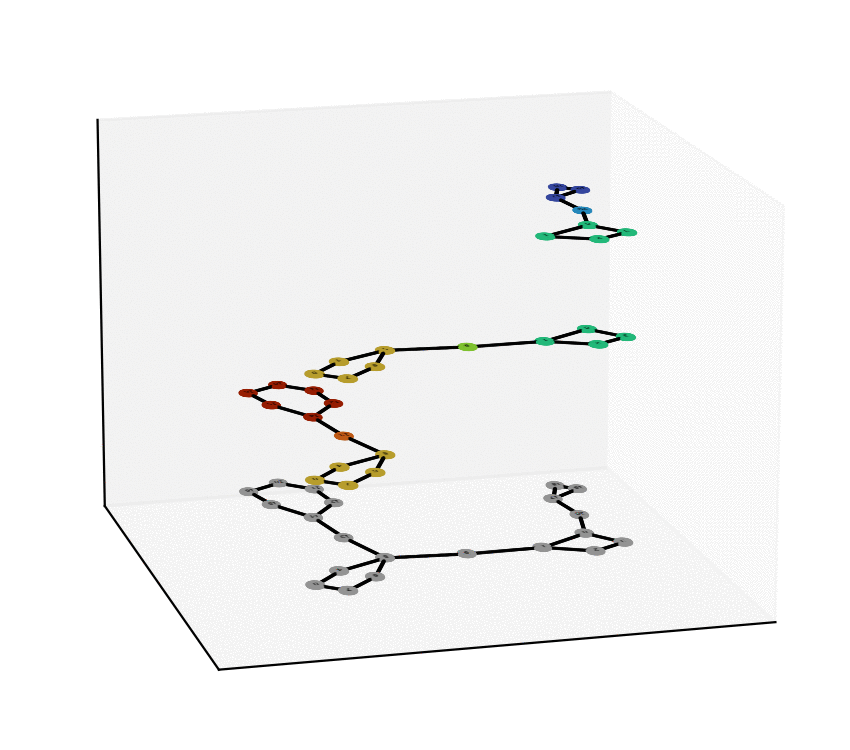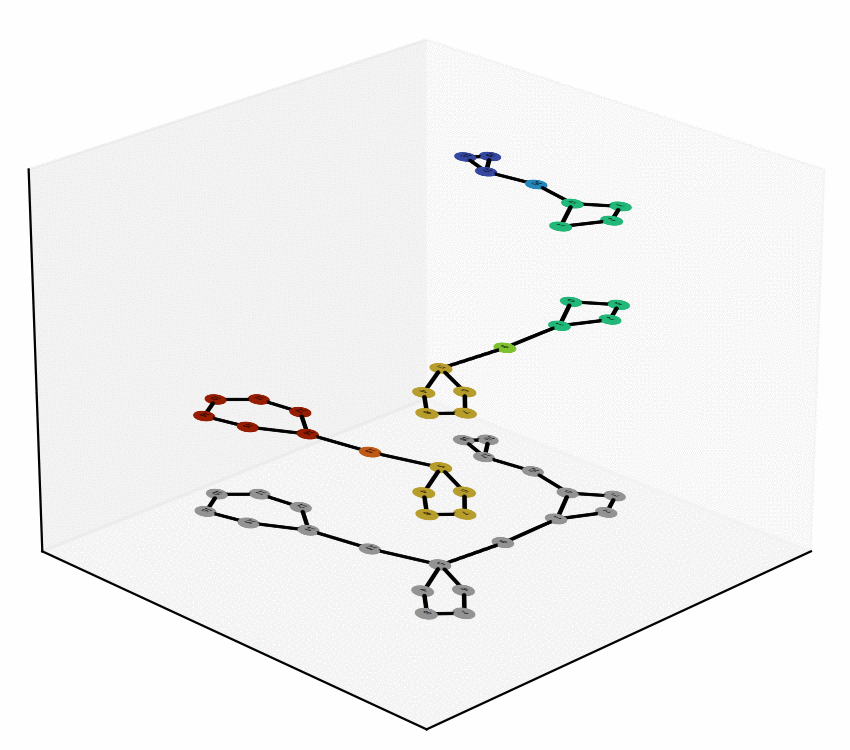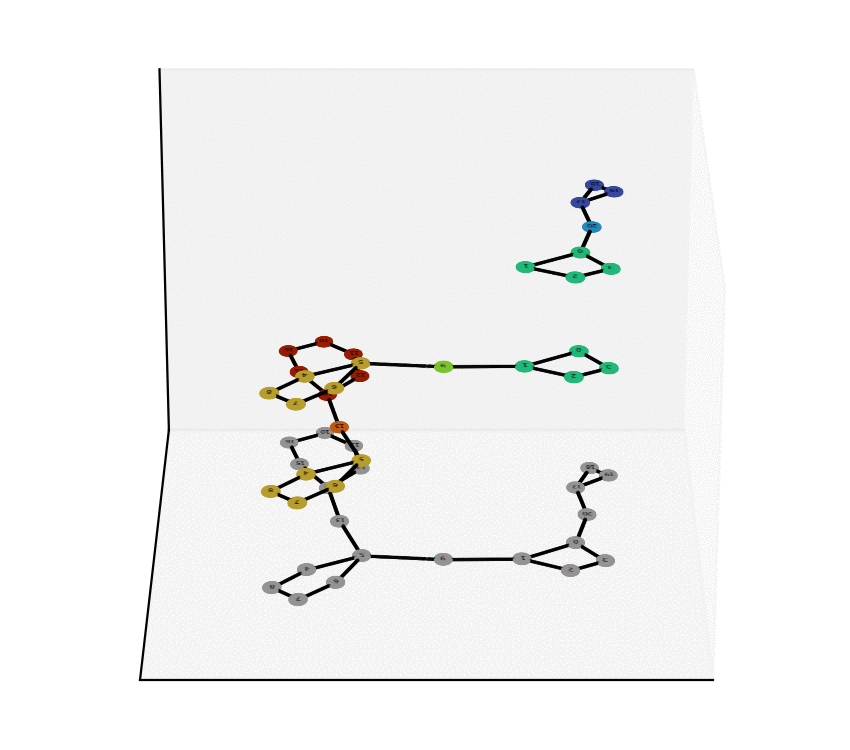
Wir haben bisher zwei Hauptmeilensteine unseres Projekts erreicht. Einer davon ist die Studie und Charakterisierung der Äquivalenz zwischen Atom-zu-Atom-Abbildungen [1,2], die es uns ermöglicht, Mengen mathematisch „wohlverhaltener“ Reaktionen zu bestimmen. Damit können wir dann die „Ausrichtung von Graphen“ erzeugen, die mit solchen Reaktionen assoziiert ist. Wir haben in der Programmiersprache Python einen Proof of Concept für den Prozess der Graph-Ausrichtung implementiert, den wir in einem kürzlich zur Überarbeitung eingereichten Manuskript beschreiben [3,4]. Eine solche Implementierung würde auf C++ erweitert, um Fälle größerer Komplexität zu untersuchen.
Technologie
Alle computergestützten Implementierungen unserer Methoden erfolgen unter Verwendung der Programmiersprachen C++ und Python sowie der dafür verfügbaren Open-Source-Bibliotheken. Alle für dieses Projekt erstellten Programme werden in GitHub-Repositories öffentlich zugänglich gemacht und enthalten Beispiele sowie Anleitungen zur Ausführung.
Ausblick
Die Anwendungen unseres Projekts bestehen in der automatischen Inferenz von Graphtransformationsregeln und der Erkundung chemischer Räume mit den inferierten Regeln; Details siehe [5].
Publikationen
[1] M. E. González Laffitte, N. Beier, N. Domschke, P. F. Stadler, Comparison of Atom Maps. MATCH Commun. Math. Comput. Chem. 90 (2023) 75–102 https://match.pmf.kg.ac.rs/issues/m90n1/m90n1_75-102.html
[2] GitHub-Repository: https://github.com/MarcosLaffitte/EEquAAM
[3]M. E. González Laffitte und P. F. Stadler. Progressive Multiple Alignment of Graphs.
[4]GitHub-Repository: https://github.com/MarcosLaffitte/Progralign
[5]Jakob L. Andersen et al. An intermediate level of abstraction for computational systems chemistry. Phil. Trans. R. Soc. A. 375. https://royalsocietypublishing.org/doi/10.1098/rsta.2016.0354
Team
Leitung
- Prof. Dr. Peter Stadler
Teammitglieder
- Marcos Emmanuel Gonzalez Laffitte
- Tomas Gatter
Partner
- Nora Beier
- Nico Domschke
- Maria Waldl
- Klaus Weinbauer
- Tieu-Long Phan
- Bioinformatik-Gruppe
- Institut für Informatik, Universität Leipzig



Dresden
ScaDS.AI Dresden/Leipzig
Bürogebäude Strehlener Straße
Strehlener Straße 12, 14
01069 Dresden
Center for Interdisciplinary Digital Sciences (CIDS)
ScaDS.AI Dresden/Leipzig
01062 Dresden
Leipzig
Löhrs Carré
Humboldtstraße 25, Uferstr. 11
04105 Leipzig
Data Science Center ScaDS.AI Leipzig
Internes Postfach: 322001
04081 Leipzig
Copyright 2026 © SCADS.AI Dresden/Leipzig – All rights reserved.