
System- und Compiler-Design für neuartige CNM/CIM-Architekturen
Projekttitel: System- und Compiler-Design für neuartige CNM/CIM-Achitekturen
Projektdauer August 2026 – Heute
Forschungsbereich: Architectures / Scalability / Security
Machine-Learning- und Datenanalyse-Anwendungen leiden zunehmend unter der hohen Latenz und dem hohen Energieverbrauch konventioneller von-Neumann-Architekturen. Computing-near-Memory (CNM) und Computing-in-Memory (CIM) stellen einen Paradigmenwechsel in Bezug auf die Recheneffizienz dar. Im Gegensatz zu traditionellen Systemen, bei denen Verarbeitungseinheiten und Hauptspeicher nur lose über Busse verbunden sind, was zu energieintensiven Datenbewegungen führt, ermöglichen CNM/CIM-Systeme Berechnungen in der Nähe des Ortes, an dem die Daten vorliegen. Im vergangenen Jahrzehnt hat die Forschung in diesem Bereich stark zugenommen, getrieben durch die steigenden Anforderungen moderner Anwendungen, wie sich deutlich am zunehmenden Datenvolumen und Verarbeitungsbedarf ML-basierter Lösungen zeigt. Obwohl CNM/CIM-Systeme im KI-Bereich eine beispiellose Leistung und Energieeffizienz bieten, sind sie nur Hardware-Experten zugänglich, was eine breitere Adoption verhindert.
Ziele
Unser Ziel ist es, die Portabilität von KI- und Big-Data-Anwendungen über bestehende CNM/CIM-Systeme und neuartige Beschleuniger-Designs hinweg zu ermöglichen, wobei Leistung, Genauigkeit und Energieeffizienz priorisiert werden.
Problemstellung
Trotz Fortschritten bei neuartigen Speicher- und Integrationstechnologien sind aktuelle Programmiermodelle oft technologiespezifisch und auf niedriger Ebene. Angesichts der erheblichen Unterschiede im Vergleich zu konventionellen Maschinen sind neue Compiler-Abstraktionen und -Frameworks entscheidend, um das Potenzial von CIM vollständig auszuschöpfen, indem sie automatische gerätebewusste und geräteunabhängige Optimierungen bereitstellen und eine breite Adoption erleichtern.
Praktisches Beispiel
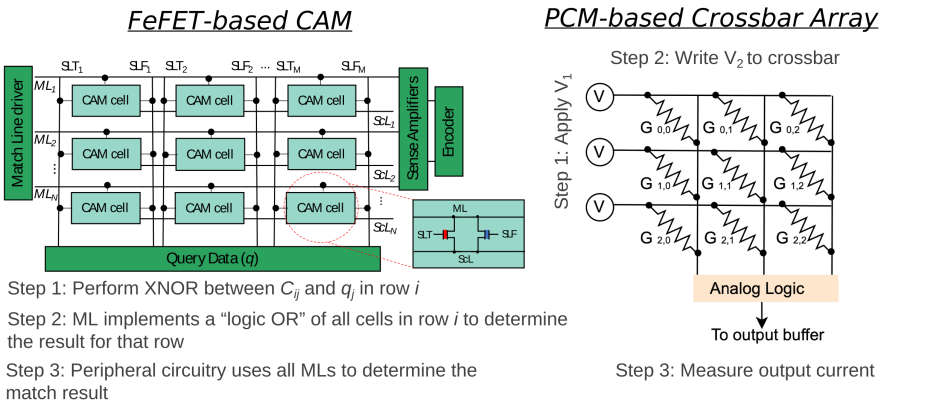
Wir haben wiederverwendbare Abstraktionen entwickelt und Kompilierungsabläufe demonstriert, die auf CIM-Systeme mit memristiven Kreuzgitter-Arrays (MCAs), inhaltsadressierbaren Speichern (CAMs), CIM-Logik-Modulen sowie auf CNM-Systeme wie UPMEM zugeschnitten sind. Weitere Informationen dazu finden sich in den unten referenzierten Publikationen.
Technologie
Unser MLIR-basierter Compiler kann Rechenprimitive von Speichergeräten sowie deren Programmiermodelle abstrahieren und den Datenfluss optimieren, unter Berücksichtigung von Hardware-Nichtidealitäten. Als Eingabe nimmt dieser Ablauf Code entgegen, der in hochgradigen (domänenspezifischen) Sprachen wie C, PyTorch und TensorFlow geschrieben ist.
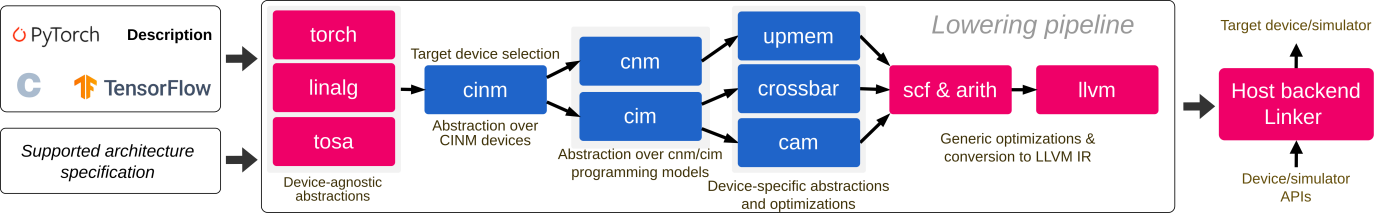
Der hierarchische Ablauf ermöglicht geräteunabhängige/gerätebewusste Analysen und Transformationen, sodass wir Rechenmuster wie Punktprodukte und Ähnlichkeitssuchen auf das am besten geeignete Hardwareziel abbilden können, wie etwa CAMs und MCAs.
Ausblick
Die Vielseitigkeit von CNM/CIM-Systemen hat sich für ein breites Anwendungsspektrum als attraktiv erwiesen, insbesondere für Deep-Learning-Aufgaben wie Inferenz und Training, die von einer um Größenordnungen verbesserten Leistung und Energieeffizienz profitieren. Dennoch erfordert die Weiterentwicklung der Automatisierung, insbesondere in heterogenen Systemen, weitere schichtenübergreifende Zusammenarbeit und Entwicklung, um die Abbildung komplexerer ML-Modelle zu ermöglichen.
Publikationen
- Asif Ali Khan, João Paulo C. de Lima, Hamid Farzaneh, Jeronimo Castrillon, „The Landscape of Compute-near-memory and Compute-in-memory: A Research and Commercial Overview“, arXiv preprint arXiv:2401.14428, Jan 2024.
- Julien Ryckaert, Michael Niemier, Zephan Enciso, Mohammad Mehdi Sharifi, X. Sharon Hu, Ian O’Connor, Alexander Graening, Ravit Sharma, Puneet Gupta, Jeronimo Castrillon, João Paulo C. de Lima, Asif Ali Khan, Hamid Farzaneh, „Smoothing Disruption Across the Stack: Tales of Memory, Heterogeneity, and Compilers“, (to appear), Proceedings of the 2024 Design, Automation and Test in Europe Conference (DATE), IEEE, pp. 1–6, Mar 2024.
- Hamid Farzaneh, João Paulo C. de Lima, Mengyuan Li, Asif Ali Khan, Xiaobo Sharon Hu, Jeronimo Castrillon, „C4CAM: A Compiler for CAM-based In-memory Accelerators“, arXiv preprint arXiv:2309.06418, Sep 2023.
- Jörg Henkel, Lokesh Siddhu, Lars Bauer, Jürgen Teich, Stefan Wildermann, Mehdi Tahoori, Mahta Mayahinia, Jeronimo Castrillon, Asif Ali Khan, Hamid Farzaneh, João Paulo C. de Lima, Jian-Jia Chen, Christian Hakert, Kuan-Hsun Chen, Chia-Lin Yang, Hsiang-Yun Cheng, „Special Session – Non-Volatile Memories: Challenges and Opportunities for Embedded System Architectures with Focus on Machine Learning Applications“, Proceedings of the 2023 International Conference on Compilers, Architecture, and Synthesis of Embedded Systems (CASES), pp. 11–20, Sep 2023.
- João Paulo C. de Lima, Asif Ali Khan, Hamid Farzaneh, Jeronimo Castrillon, „Efficient Associative Processing with RTM-TCAMs“, In Proceeding: 1st in-Memory Architectures and Computing Applications Workshop (iMACAW), co-located with the 60th Design Automation Conference (DAC’23), 2pp, Jul 2023.
- Asif Ali Khan, Hamid Farzaneh, Karl F. A. Friebel, Clément Fournier, Lorenzo Chelini, Jeronimo Castrillon, „CINM (Cinnamon): A Compilation Infrastructure for Heterogeneous Compute In-Memory and Compute Near-Memory Paradigms“, arXiv preprint arXiv:2301.07486, Jan 2023.
Team
Leitung
- Prof. Dr. Jeronimo Castrillon
Teammitglieder
- Joao Paulo C. de Lima
- Asif Ali Khan
- Hamid Farzaneh
Partner
- Mahta Mayahinia, Mehdi B. Tahoori (Karlsruher Institut für Technologie, DE)
- Mengyuan Li, Xiaobo S. Hu (University of Notre Dame, US)
- Alex K. Jones (University of Pittsburg, US)



Dresden
ScaDS.AI Dresden/Leipzig
Bürogebäude Strehlener Straße
Strehlener Straße 12, 14
01069 Dresden
Center for Interdisciplinary Digital Sciences (CIDS)
ScaDS.AI Dresden/Leipzig
01062 Dresden
Leipzig
Löhrs Carré
Humboldtstraße 25, Uferstr. 11
04105 Leipzig
Data Science Center ScaDS.AI Leipzig
Internes Postfach: 322001
04081 Leipzig
Copyright 2026 © SCADS.AI Dresden/Leipzig – All rights reserved.