November 3, 2026
EMNLP 2026: SAC Highlight Award
Forschung
Vom 24. bis 29. Oktober 2026 fand in Budapest (Ungarn) die 2026 Conference on Empirical Methods in Natural Language Processing (EMNLP 2026) statt. ScaDS.AI Dresden/Leipzig nahm mit einer Vielzahl von Beiträgen an der Konferenz teil.
SAC Highlight Award
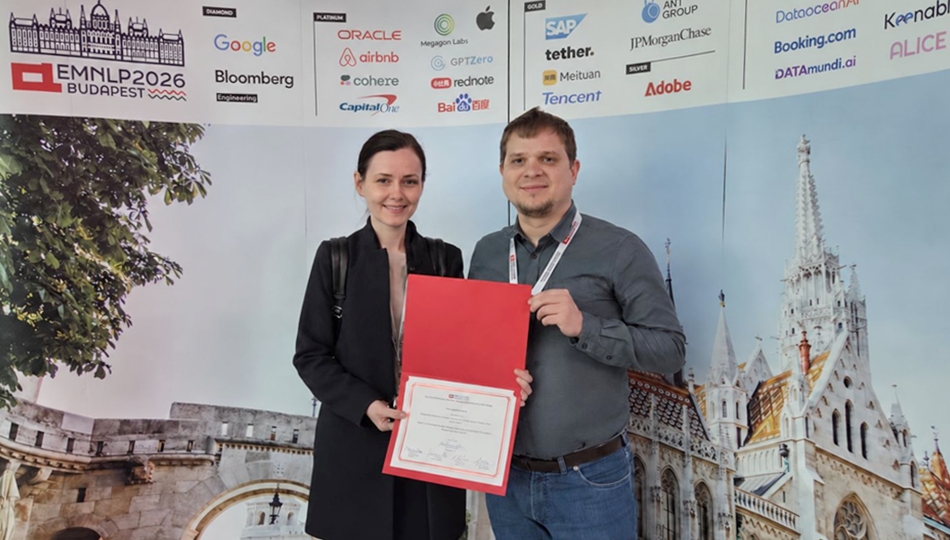
Das Paper „Gold vs. Translation“ wurde bei der EMNLP 2026 in Budapest mit einem Senior Area Chair (SAC) Highlight Award ausgezeichnet. Die Arbeit entstand im Rahmen eines gemeinsamen Forschungsnetzwerks, an dem das Alexandra Instituttet, die TU Dresden und ScaDS.AI Dresden/Leipzig beteiligt waren.
Mit der Auszeichnung heben die Senior Area Chairs, die jeweils einen Themenbereich der Konferenz betreuen, besonders bemerkenswerte Arbeiten hervor. In diesem Jahr erhielten 22 Paper den Preis. Insgesamt verzeichnete die EMNLP, eine der führenden internationalen Konferenzen für automatische Sprachverarbeitung, mehr als 17.000 Einreichungen.
Gold vs. Translation: Are We Measuring Language, Knowledge, or Locality in Translated Benchmarks?
Viele KI-Sprachmodelle werden in unterschiedlichen Sprachen mit übersetzten englischsprachigen Benchmarks bewertet. Doch eine Übersetzung ergänzt nicht einfach Fragen zu dänischem Recht, schwedischer Sportgeschichte, der Geologie der estnischen Insel Hiiumaa oder der Geschichte des Sámi Grand Prix, wenn diese im Ausgangstest fehlen. Die Studie fragt deshalb: Sagen übersetzte Benchmarks etwas darüber aus, wie gut Sprachmodelle sprach- und kulturspezifisches Wissen beherrschen?
Um das zu prüfen, nutzt die Studie sieben Benchmarks als Vergleichsmaßstab, die ursprünglich in fünf nordischen und baltischen Sprachen entstanden sind. Die Benchmarks stammen aus Schul- und Hochschulzugangsprüfungen, beruflichen Zulassungsprüfungen und Einbürgerungstests oder bestehen aus Quiz- und Faktenfragen. Neben allgemeinem Fachwissen prüfen sie, je nach Benchmark unterschiedlich stark, auch lokales Wissen zu Recht, Geschichte, Geografie und Kultur. Die Ergebnisse von 29 Sprachmodellen auf diesen Benchmarks wurden mit den Werten auf DeepL-Übersetzungen von MMLU verglichen – einem ursprünglich englischsprachigen Multiple-Choice-Benchmark, der breites schulisches sowie akademisches Wissen abfragt und teilweise Kenntnisse des US-amerikanischen Kontexts voraussetzt.
Kern der Arbeit ist ein statistischer Ansatz, der misst, welche zusätzliche Information ein übersetzter Benchmark liefert. Er berücksichtigt zunächst, was sich bereits aus Modellgröße und Sprachverständnis über die Testergebnisse ableiten lässt. Erst dann bestimmt er, wie viel der übersetzte Benchmark darüber hinaus über die Leistung auf den Originaltests verrät und wie verlässlich dieser Beitrag ist.
Dieser Schritt ist nötig, weil Ranglisten täuschen können: Leistungsstarke Modelle liegen in sehr unterschiedlichen Benchmarks vorne. Eine ähnliche Reihenfolge sagt daher wenig über den tatsächlichen Informationswert aus. So stimmten bei schwedischen Prüfungsaufgaben und beim dänischen Einbürgerungstest die Ranglisten jeweils stark mit denen des übersetzten Benchmarks überein. Die Ergebnisse des übersetzten Benchmarks halfen jedoch unterschiedlich stark dabei, die Leistungsunterschiede zwischen den Modellen zu erklären. Bei den schwedischen Prüfungsaufgaben war dieser zusätzliche Beitrag mehr als zehnmal so groß wie beim dänischen Einbürgerungstest.
Mit diesem Vorgehen wird messbar, was sich bislang nur vermuten ließ: Übersetzte Benchmarks sind vor allem dann aussagekräftig, wenn sich die abgefragten Wissensgebiete überschneiden, etwa bei schulischen Inhalten. Für lokales Wissen ist ihre Aussagekraft oft begrenzt. Und selbst innerhalb einer Sprache liefert derselbe übersetzte Benchmark je nach Originaltest unterschiedlich viel zusätzliche Information. Gerade wenn Sprachmodelle in Verwaltung, Recht oder Bildung eines Landes eingesetzt werden sollen, zeigt der Ansatz, ob übersetzte Benchmarks dafür ausreichen oder lokal entwickelte Aufgaben nötig sind.
Unsere Beiträge zu EMNLP 2026
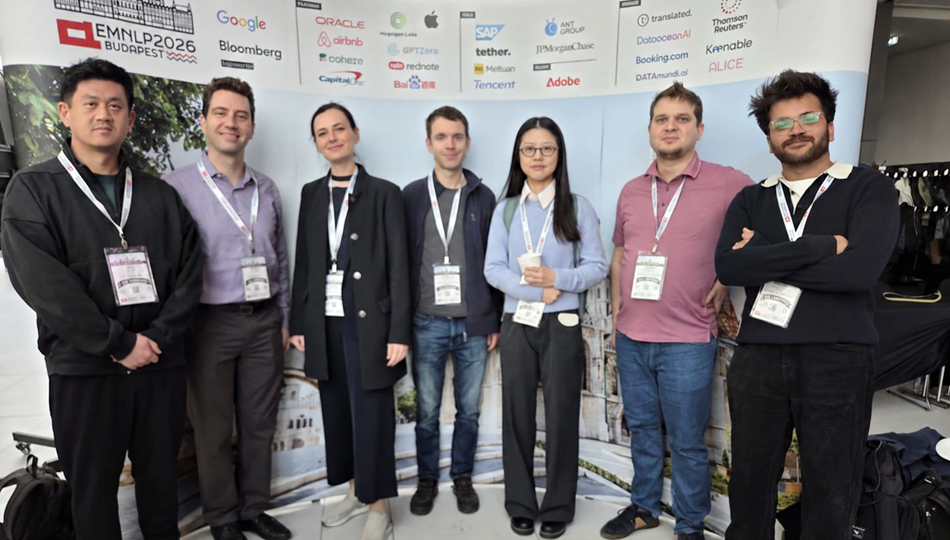
Paper
- Politov, A., Vergunova, I., Jäkel, R., & Färber, M. (2026). Energy-Aware Benchmarking of Generative Information Extraction. In Findings of the Association for Computational Linguistics: EMNLP 2026 (pp. 42668-42691).
- Qu, Z., & Färber, M. (2026). Vital Trace: Protocol-Constrained Patient-State Reasoning for Longitudinal Clinical Trajectories.arXiv preprint arXiv:2602.12833.
- Saeed, M., & Razniewski, S. (2026). LLMpedia: A Transparent Framework to Materialize an LLM’s Encyclopedic Knowledge at Scale. arXiv preprint arXiv:2603.24080.
- Sallouh, A., Popovič, N., & Färber, M. (2026). Does Modern Standard Arabic (MSA) Dominate Arabic Dialects in LLMs? A Representation-Level Analysis. In Proceedings of the 2026 Conference on Empirical Methods in Natural Language Processing (pp.49531–49543).
- Thellmann, K., Stadler, B., Smart, D. S., Färber, M., & Lehmann, J. (2026, October). Gold vs. Translation: Are We Measuring Language, Knowledge, or Locality in Translated Benchmarks?. In Proceedings of the 2026 Conference on Empirical Methods in Natural Language Processing (pp. 657-688).
- Wilinski, J., & Färber, M. (2026). SciEmbed: Citation-Context Supervision for Scientific Document Embeddings. In Findings of the Association for Computational Linguistics: EMNLP 2026 (pp. 43793-43819).
- Yuan, S., Im, K., & Färber, M. (2026). Analyzing Bias in False Refusal Behavior of Large Language Models for Hate Speech Detoxification. In Findings of the Association for Computational Linguistics: EMNLP 2026 (pp. 6741-6769).
Beiträge zu Workshops
11th Workshop on Automated Knowledge Base Construction (AKBC 2026)
- Ghosh, S., Giordano, L., Hu, Y., Nguyen, T. Razniewski, S. (2026). Auditing a KB Elicitation of Frontier LLM Knowledge: A Multi-dimensional Analysis of GPTKB v1.5. In Proceedings of the 11th Workshop on Automated Knowledge Base Construction (AKBC 2026) (pp. 8-18).
- Razniewski, S., Ghosh, S., Giordano, L., Hu, Y., Kowalzik, J., Nguyen, T. (2026). Epistemic Twins: Enabling a Symbolic Science of Language Model Knowledge. In Proceedings of the 11th Workshop on Automated Knowledge Base Construction (AKBC 2026) (pp. 1-7).
- Schrader, T., Friedrich, A., Razniewski, S., Lange, L. (2026). The Canonical Order Problem: When Large Language Models Are Unreliable Knowledge Bases for Multi-Valued Relations. In Proceedings of the 11th Workshop on Automated Knowledge Base Construction (AKBC 2026) (pp. 45-55).
Third Workshop on Uncertainty-Aware NLP
- Müller, P., Popovič, N., Färber, M. & Steinbach, P. (2026). Semantic Calibration Prevails Where Token Confidence Fails: Benchmarking Long-Form Scientific QA. arXiv preprint arXiv:2602.00279.
System Demonstrations
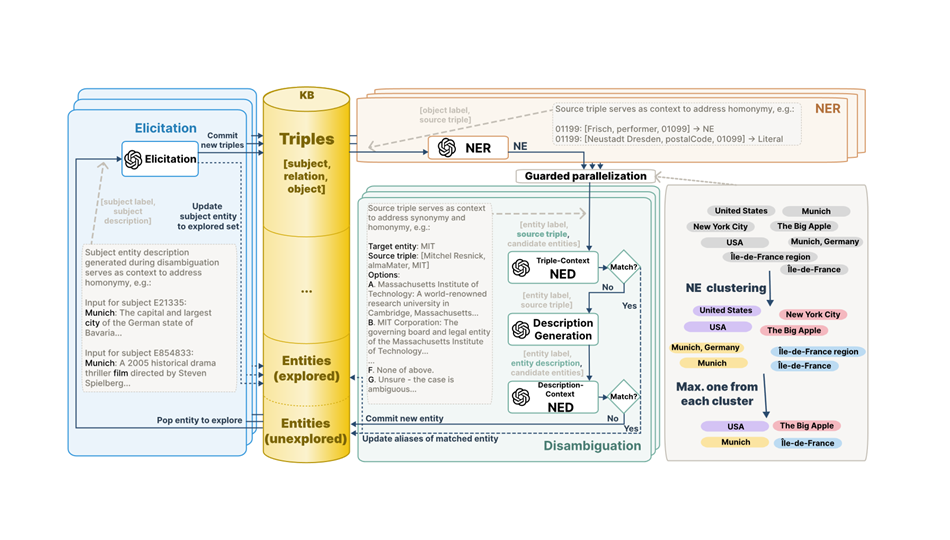
- Hu, Y., Nguyen, T., Razniewski, S. (2026). GPTKB 2.0: Browsing, Querying, and Auditing a Disambiguated LLM-Derived Knowledge Base. arXiv:2608.06992
EMNLP 2026
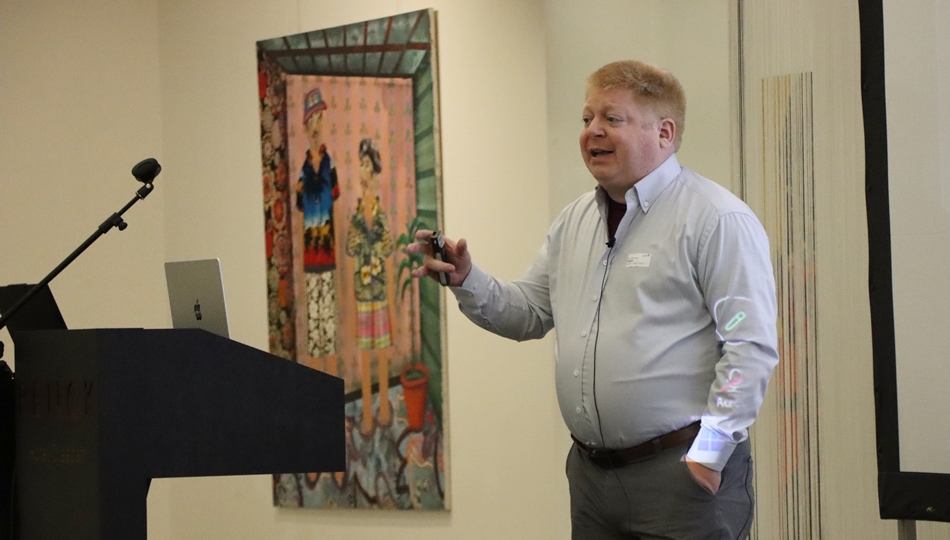
Die EMNLP 2026 brachte Forschende aus aller Welt zusammen, die Forschungsergebnisse aus einer Vielzahl von Bereichen der natürlichen Sprachverarbeitung (NLP) vorstellten, darunter Informationsgewinnung und Text Mining, LLM-Agenten, maschinelles Lernen für NLP und vieles mehr. Die Konferenz wurde von der Special Interest Group on Linguistic Data & Corpus-based Approaches to Natural Language Processing (SIGDAT) organisiert.
funded by:

ScaDS.AI Dresden/Leipzig (Zentrum für skalierbare Datenanalyse und Künstliche Intelligenz) ist ein Zentrum für Data Science, Künstliche Intelligenz und Big Data mit Standorten in Dresden und Leipzig.


Dresden
Besucheradresse
Technische Universität Dresden
ScaDS.AI Dresden/Leipzig
Bürogebäude Strehlener Straße
Strehlener Straße 12, 14
01069 Dresden
ScaDS.AI Dresden/Leipzig
Bürogebäude Strehlener Straße
Strehlener Straße 12, 14
01069 Dresden
Postalische Adresse
Technische Universität Dresden
Center for Interdisciplinary Digital Sciences (CIDS)
ScaDS.AI Dresden/Leipzig
01062 Dresden
Center for Interdisciplinary Digital Sciences (CIDS)
ScaDS.AI Dresden/Leipzig
01062 Dresden
Leipzig
Besucheradresse
ScaDS.AI Dresden/Leipzig
Löhrs Carré
Humboldtstraße 25, Uferstr. 11
04105 Leipzig
Löhrs Carré
Humboldtstraße 25, Uferstr. 11
04105 Leipzig
Postalische Adresse
Universität Leipzig
Data Science Center ScaDS.AI Leipzig
Internes Postfach: 322001
04081 Leipzig
Data Science Center ScaDS.AI Leipzig
Internes Postfach: 322001
04081 Leipzig
Copyright 2026 © SCADS.AI Dresden/Leipzig – All rights reserved.