
Computergestützte Wirkstoffforschung der nächsten Generation für kleine Moleküle
Projekttitel: Computergestützte Wirkstoffforschung der nächsten Generation für kleine Moleküle
Projektdauer: Mai 2021 – Mai 2025
Forschungsbereich: Biowissenschaften und Medizin
Der Bereich der computergestützten Wirkstoffforschung befindet sich im Wandel. Dank der Verfügbarkeit von Proteinstrukturen, umfangreicher chemischer Räume und Fortschritten im geometrischen Deep Learning stehen wir kurz davor, bedeutende Fortschritte zu erzielen. Dennoch bestehen weiterhin einige Herausforderungen.
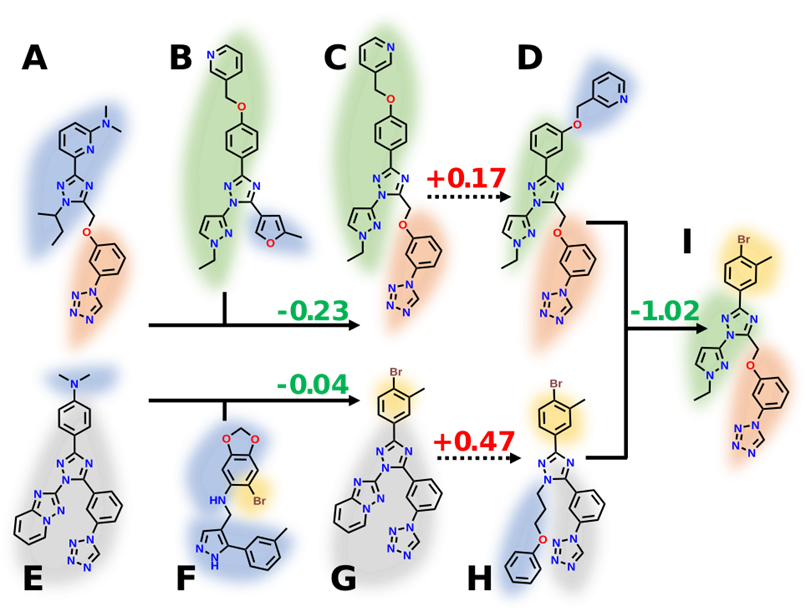
Wir haben eine neuartige Methode entwickelt, um extrem große chemische Räume mit Milliarden von Molekülen zu durchforsten. Unser Ansatz, bekannt als „RosettaEvolutionaryLigand“, hat diese Herausforderung erfolgreich gemeistert. Während der Entwicklung haben wir zwei zentrale Probleme identifiziert. Erstens ist der von uns verwendete Docking-Algorithmus zwar präzise, aber rechenintensiv. Vorläufige Experimente zeigten, dass die Kombination fortschrittlicher Diffusionsmethoden mit Monte-Carlo-Sampling beide Techniken verbessert. Zweitens mangelt es bestehenden Methoden zur Affinitätsvorhersage an Präzision, was für die Wirkstoffforschung entscheidend ist, von der Machine-Learning-Community jedoch oft übersehen wird.
Ziele
- Durchsuchen chemischer Räume, die Milliarden von Molekülen umfassen.
- Verbesserung der Docking-Methoden hinsichtlich Präzision und Geschwindigkeit.
- Entwicklung einer robusten Affinitätsvorhersage, um zuverlässige Kriterien für die Auswahl von Kandidaten für In-vitro-Tests bereitzustellen.
Problemstellung
Die Entwicklung neuer kleinmolekularer Arzneimittel ist aufgrund des riesigen chemischen Raums eine Herausforderung. Computerberechnungen helfen bei der Vorauswahl von Kandidaten und reduzieren so die Anzahl der Tests und Iterationszyklen, die zur Entdeckung robuster erster Treffer erforderlich sind. Etablierte Methoden weisen jedoch erhebliche Mängel auf, und neue Methoden des maschinellen Lernens stützen sich aufgrund begrenzter Fachkenntnisse oft auf künstliche Benchmarks.
Praxisbeispiel
Wir nahmen an der ersten Runde der CACHE-Challenge teil und prognostizierten einen potenziellen Wirkstoffkandidaten für ein Protein, das mit der Parkinson-Krankheit in Verbindung steht. Unter 145 eingereichten Molekülen entdeckten wir fünf vielversprechende Treffer. Damit konnten wir das Potenzial unseres evolutionären Algorithmus unter Beweis stellen, gleichzeitig wurden jedoch auch die Grenzen unseres Docking-Protokolls und unserer Bewertungsfunktion deutlich.
Technologie
Wir nutzen PyTorch für maschinelles Lernen und die e3nn-Bibliothek für Tensorproduktberechnungen in molekularen Systemen. RDKit bereitet Eingaben für kleine Moleküle vor, während Rosetta große Biomoleküle verarbeitet. Unsere Entwicklung erfolgt in C++ und Python unter Nutzung von Hochleistungs-Rechenclustern mit OpenMPI und leistungsstarken GPUs mit CUDA.
Ausblick
Wir planen, modernste Docking-Protokolle zu fertigzustellen und lokale, geometrieabhängige Faltungskerne für die Vorhersage von Wechselwirkungen zwischen Molekülen zu entwickeln. Zukünftige Arbeiten werden sich auf die Integration dieser Kerne in tiefe neuronale Netze zur Affinitätsvorhersage konzentrieren. Darüber hinaus streben wir die Entwicklung eines Affinitätsprädiktors an, der nicht auf komplexen Strukturen basiert, sowie die Entwicklung eines Grundmodells für die Vorhersage molekularer Merkmale, das sich an multimodale Umgebungen und spezifische Aufgaben anpassen lässt.
Publikationen
- REvoLd: Ultra-Large Library Screening with an Evolutionary Algorithm in Rosetta
- Utilizing Ultra-large library screening in Rosetta: A Case Report for Novel Binder of the WD-Repeat Domain of Leucine-Rich Repeat Kinase 2
Team
Teamleitung
- Prof. Dr. Jens Meiler (Leipzig University)
Teammitglieder
- Paul Eisenhuth (Leipzig University)



Dresden
ScaDS.AI Dresden/Leipzig
Bürogebäude Strehlener Straße
Strehlener Straße 12, 14
01069 Dresden
Center for Interdisciplinary Digital Sciences (CIDS)
ScaDS.AI Dresden/Leipzig
01062 Dresden
Leipzig
Löhrs Carré
Humboldtstraße 25, Uferstr. 11
04105 Leipzig
Data Science Center ScaDS.AI Leipzig
Internes Postfach: 322001
04081 Leipzig
Copyright 2026 © SCADS.AI Dresden/Leipzig – All rights reserved.