
CORAL
Titel: Constrained Retrieval Augmented Language Models (CORAL)
deutsch: Eingeschränkte Sprachmodelle mit erweiterter Suche
Projektdauer: 10/2024 – 09/2027
Forschungsbereich: KI-Algorithmen und -Methoden, Sprache verstehen
CORAL ist kein Projekt am ScaDS.AI Dresden/Leipzig, allerdings sind assoziierte Mitglieder des ScaDS.AI Dresden/Leipzig an dem Projekt beteiligt.
Der praktische Einsatz großer Sprachmodelle (LLMs) ist häufig durch verschiedene Einschränkungen begrenzt, darunter hohe Rechenkosten, gesetzliche Anforderungen an Trainingsdaten oder die Rückverfolgbarkeit generierter Texte. Das CORAL-Projekt befasst sich mit diesen Herausforderungen und zielt darauf ab, Methoden zur Erstellung und Nutzung von Sprachmodellen zu entwickeln, die trotz solcher Einschränkungen funktionieren. Zu diesem Zweck untersuchen wir systematisch Ansätze für das eingeschränkte Training von LLMs und die suchgestützte Textgenerierung. Zusammen mit unseren (assoziierten) Partnern aus dem Finanz- und Kultursektor erforschen wir zudem die Übertragbarkeit und Verallgemeinerbarkeit dieser Methoden und Modelle.
Ziele
Das Forschungsprojekt CORAL zielt darauf ab, Methoden für die Konstruktion und Nutzung von LLMs zu untersuchen, die rechtlichen, technischen und qualitativen Beschränkungen unterliegen. Wir konzentrieren uns auf zwei zentrale Kriterien, die für den professionellen Einsatz von LLMs unverzichtbar sind: die Erfüllung der rechtlichen Anforderungen an die Trainingsdaten von LLMs und die referenziellen Herkunft der generierten Texte.
Problem
Wir untersuchen, ob sich praktisch nutzbare Sprachmodelle anhand von Texten trainieren lassen, die nur in verschiedenen eingeschränkten Formen verfügbar sind. Darüber hinaus entwickeln wir Methoden zur Generierung von Texten, die Fachwissen einbeziehen und Quellenangaben enthalten. Insbesondere sollte die Reproduktion von Trainingsdaten vermieden werden, während gleichzeitig die angegebenen Quellen genau referenziert werden. Diese Methoden werden durch umfangreiche Experimente evaluiert und in Zusammenarbeit mit Partnern aus dem Finanzsektor, GLAM-Institutionen und der Industrie getestet.
Praxisbeispiele
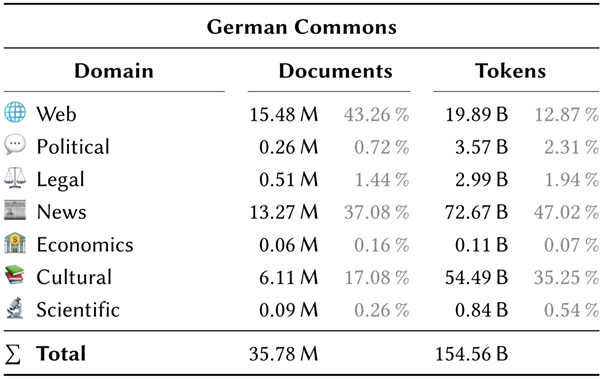
Ein aktuelles Ergebnis ist German Commons, die bislang größte Sammlung von Texten in deutscher Sprache mit offener Lizenz. German Commons ist ein Datensatz, der zum Trainieren von Sprachmodellen verwendet werden kann. Für diesen Prozess sind große Mengen an Text erforderlich, die häufig aus Web-Crawls mit unklaren Lizenzbedingungen stammen. German Commons wurde hingegen sorgfältig aus nachweislich lizenzierten Trainingsdaten zusammengestellt. Dadurch wird die Entwicklung wirklich offener deutscher LLMs ermöglicht.
- Daten: https://huggingface.co/datasets/coral-nlp/german-commons
- Code: https://github.com/coral-nlp/llmdata
Technologie
Unsere Forschung konzentriert sich auf Encoder- und Decoder-Modelle, die jeweils für unterschiedliche Anwendungen geeignet sind. Decoder-Modelle, die Technologie hinter Chat-Assistenten wie ChatGPT, haben in letzter Zeit die meiste Aufmerksamkeit erhalten. Obwohl ihre Verbesserungen bemerkenswert sind, bestehen weiterhin Probleme wie hohe Trainingskosten, Unsicherheiten hinsichtlich der Lizenzierung von Trainingsdaten oder das Risiko der Textwiedergabe. Unser Ziel ist es, solche Modelle unter bestimmten Einschränkungen zu trainieren, um neue Anwendungen zu erschließen und LLMs einem breiteren Publikum zugänglich zu machen.
Ausblick
In drei Schlüsselbereichen der Sprachmodellentwicklung und -nutzung der Gesellschaft, Wissenschaft und Industrie werden innovative Ergebnisse und Erkenntnisse erwartet:
- Berücksichtigung bisher eingeschränkter Trainingsdaten,
- Modellarchitekturen, die Einschränkungen berücksichtigen, z. B. durch die Verhinderung der Reproduktion von Trainingsdaten.
- Verweis auf relevante und zuverlässige Quellen, auf denen der generierte Text basiert.
Die beispielhafte Übertragung dieser Ansätze wird sowohl ihre Flexibilität als auch ihre Wirksamkeit deutlich machen.
Publikationen
- Lukas Gienapp, Christopher Schröder, Stefan Schweter, Christopher Akiki, Ferdinand Schlatt, Arden Zimmermann, Phillipe Genêt, and Martin Potthast. The German Commons – 154 Billion Tokens of Openly Licensed Text for German Language Models. CoRR, abs/2510.13996, October 2025.
- Lukas Gienapp, Martin Potthast, Harrisen Scells, and Eugene Yang. Topic-Specific Classifiers are Better Relevance Judges than Prompted LLMs. CoRR, abs/2510.04633, October 2025.
- Lukas Gienapp, Niklas Deckers, Martin Potthast, and Harrisen Scells. Learning Effective Representations for Retrieval Using Self-Distillation with Adaptive Relevance Margins. In 15th International Conference on Innovative Concepts and Theories in Information Retrieval (ICTIR 2025), July 2025. ACM.
- Jan Heinrich Merker, Maik Fröbe, Benno Stein, Martin Potthast, and Matthias Hagen. Axioms for Retrieval-Augmented Generation. In 15th International Conference on Innovative Concepts and Theories in Information Retrieval (ICTIR 2025), July 2025. ACM.
- Lukas Gienapp, Tim Hagen, Maik Fröbe, Matthias Hagen, Benno Stein, Martin Potthast, and Harrisen Scells. The Viability of Crowdsourcing for RAG Evaluation. In 48th International ACM SIGIR Conference on Research and Development in Information Retrieval (SIGIR 2025) , pages 159 – 169 , July 2025 . ACM.
- Julia Romberg, Christopher Schröder, Julius Gonsior, Katrin Tomanek, and Fredrik Olsson. Have LLMs Made Active Learning Obsolete? Surveying the NLP Community. In CoRR, abs/2503.09701, March 2025.
Weitere Informationen
Team
Leitung
- Prof. Dr. Gerhard Heyer (Institut für Angewandte Informatik e. V.)
Teammitglieder
- Lukas Gienapp
- Christopher Schröder
- Prof. Martin Potthast
- Prof. Gerhard Heyer
Partner
- Institut für Angewandte Informatik e. V.
- Universität Kassel
- Hochschule Anhalt
- Deutsche Nationalbibliothek



Dresden
ScaDS.AI Dresden/Leipzig
Bürogebäude Strehlener Straße
Strehlener Straße 12, 14
01069 Dresden
Center for Interdisciplinary Digital Sciences (CIDS)
ScaDS.AI Dresden/Leipzig
01062 Dresden
Leipzig
Löhrs Carré
Humboldtstraße 25, Uferstr. 11
04105 Leipzig
Data Science Center ScaDS.AI Leipzig
Internes Postfach: 322001
04081 Leipzig
Copyright 2026 © SCADS.AI Dresden/Leipzig – All rights reserved.