
LLMpedia
Projektitel: LLMpedia: Ein transparentes Rahmenwerk zur Umsetzung des enzyklopädischen Wissens eines LLM in großem Maßstab
Projektdauer: Gestartet in 2026
Forschungsbereich: Sprache verstehen, Wissensrepräsentation und Wissensmodellierung
LLMpedia ist eine groß angelegte Enzyklopädie, die vollständig aus dem parametrischen Speicher großer Sprachmodelle generiert wird – ohne Rückgriff auf externe Quellen. Sie ist als vernetzte Ressource analog zu Wikipedia aufgebaut und umfasst fast eine Million Artikel aus drei Modellfamilien (GPT-5-mini, DeepSeek-V3.2, Llama 3.3-70B). Das Projekt stellt eine skalierbare Open-Source-Pipeline vor, die die Artikelplanung, die dynamische Erstellung von Gliederungen sowie eine dreistufige Pipeline zur Bereinigung von Entitäten umfasst.
Kontrollierte Experimente zeigen, dass eine einfache Einbindung von Persönlichkeiten auf Prompt-Ebene die politische Framing in generierten Inhalten in großem Maßstab messbar verändert. LLMpedia ermöglicht zudem eine neuartige Methode zur Bewertung des Wissens von LLMs. Bei GPT-5-mini liegt die nachprüfbare Richtigkeit bei Themen, die in Wikipedia behandelt werden, bei 74,7 % – mehr als 15 Prozentpunkte unter den Werten früherer Benchmarks. LLMpedia ist vollständig offen: Alle Daten, der Code, die Prompts und die Bewertungsergebnisse sind öffentlich zugänglich.
Ziele
LLMpedia vereint die Bewertung der Sachlichkeit und die Konkretisierung von Wissen in einem einzigen Framework. Das Projekt verfolgt folgende Ziele:
- Erstellung eines transparenten, reproduzierbaren Datensatzes für die NLP-Forschung
- Aufzeigen der Diskrepanz zwischen der Genauigkeit von Benchmarks und der Sachlichkeit in der realen Welt bei offenen Fragen
- Entwicklung skalierbarer Methoden für den Aufbau parametrischer Enzyklopädien
- Untersuchung, wie redaktionelle Rahmenbedingungen durch die Gestaltung von Prompts KI-generierte Inhalte in großem Maßstab beeinflussen
Problemstellung
Der Genauigkeitswert, den die meisten Menschen als Maßstab für modernste LLMs anführen, entspricht nicht der Genauigkeit, die in der Praxis erzielt wird. LLMpedia beweist dies – in großem Maßstab, mit über einer Million Artikeln mit offenen Fragen.
Standard-Benchmarks wie MMLU melden eine sachliche Genauigkeit von über 90 % für modernste LLMs – eine Schlagzeilenzahl, die häufig herangezogen wird, um eine nahezu menschliche Zuverlässigkeit zu behaupten. Diese Benchmarks testen jedoch nur das Wissen, von dem die Bewerter annahmen, dass es abgefragt werden würde, was zu einem Verfügbarkeitsbias führt: Die Modelle erscheinen bei einem festgelegten Fragenkatalog als äußerst sachlich korrekt, während weite Bereiche ihres Wissens ungetestet bleiben.
LLMpedia widerlegt diese Annahme, indem es Wissen zu fast einer Million Themen in Form von Freitext abfragt – dem Format, das echte Nutzer tatsächlich erhalten. Die Ergebnisse sind ernüchternd:
| Evaluation Setting | Accuracy | vs. MMLU | Source |
|---|---|---|---|
| Benchmark (MMLU / HLE) | ~90% | – | Published |
| Wikipedia-Covered Subjects (LLMpedia) | 74.7% | −15.3 pp | LLMpedia |
| Frontier Subjects (absent from Wikipedia) | 63.2% | −26.8 pp | LLMpedia |
Die Diskrepanz ist kein Rundungsfehler – sie ist struktureller Natur. Benchmarks mit festgelegten Fragen überbewerten die faktische Zuverlässigkeit bei offenen Fragen, da sie nur das prüfen, was der Bewerter zu fragen gedachte. LLMpedia liefert das vollständige Bild: Wikipedia deckt lediglich 61 % der Entitäten ab, die das Modell selbst ermittelt, und drei Modellfamilien haben nur 7,3 % ihrer Themen gemeinsam – was bestätigt, dass das materialisierte Wissen weitaus modellspezifischer ist, als es die Ranglistenwerte vermuten lassen.
Wichtigste Erkenntnis: Der Wechsel von Benchmarks im MMLU-Stil zu einer offenen enzyklopädischen Bewertung zeigt einen Genauigkeitsrückgang von 15 Punkten bei bekannten Themen und von fast 27 Punkten bei neuen Themenbereichen. Dies ist der Verfügbarkeitsbias im großen Maßstab – und LLMpedia ist das erste Framework, das ihn systematisch quantifiziert.
Praxisbeispiel
LLMpedia ist öffentlich einsehbar. Nutzer können KI-generierte Enzyklopädieartikel zu Themen wie Städten – beispielsweise Dresden – oder historischen Persönlichkeiten durchstöbern. Die Plattform dient als Forschungskorpus zur Untersuchung von Faktengenauigkeit, Wissensabdeckung, Suchverhalten und redaktioneller Voreingenommenheit in von großen Sprachmodellen (LLM) generierten Inhalten – und als transparentes Gegenstück zu undurchsichtigen Systemen wie Grokipedia.
Technologie
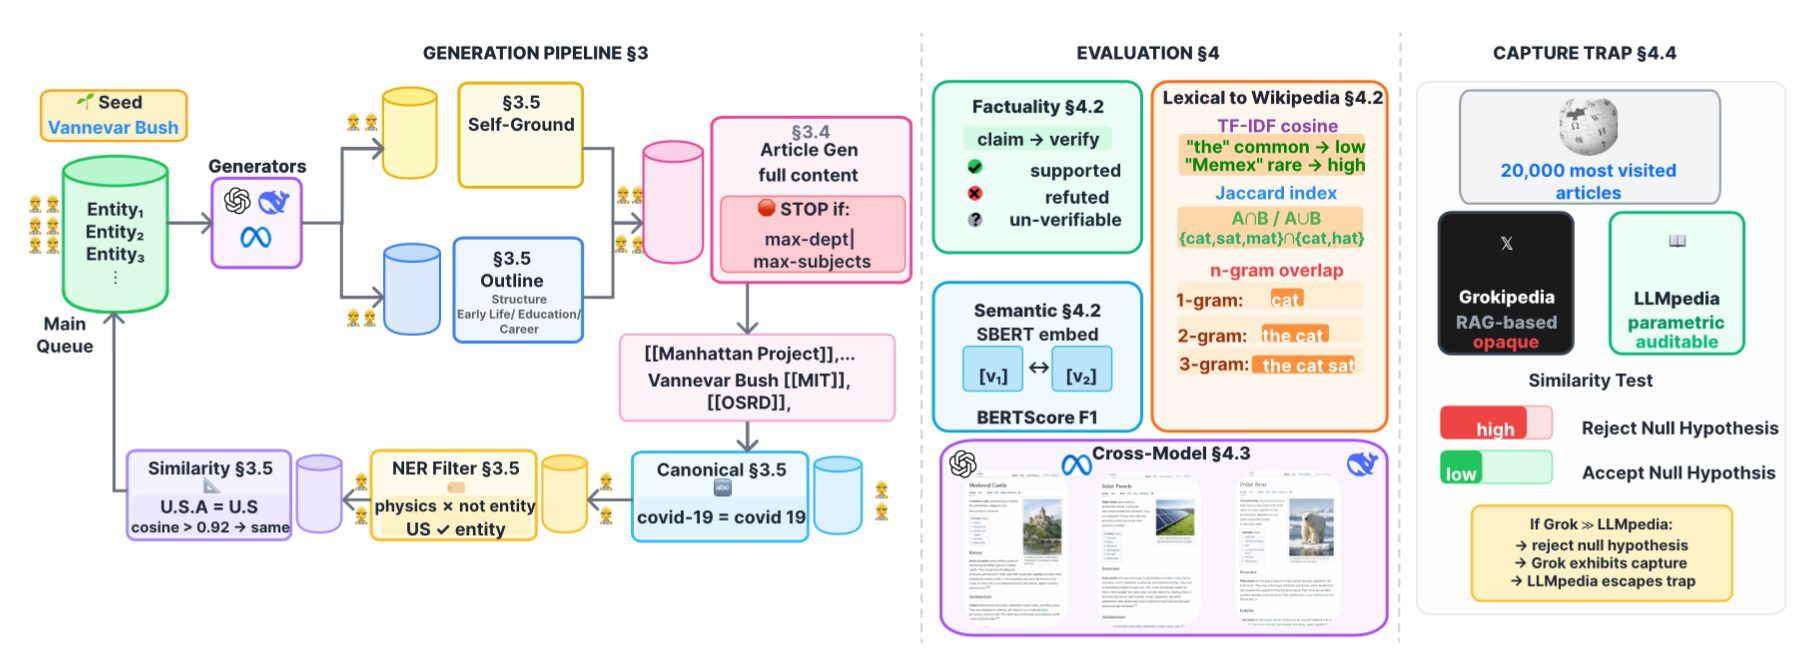
LLMpedia nutzt eine Pipeline mit Breitensuche (BFS), die von einer einzigen Entität ausgeht (Vannevar Bush für Läufe im allgemeinen Wissensbereich) und sich durch die Generierung von Artikeln im Wikipedia-Stil im Wikitext sowie die Extraktion von [[Wikilinks]] als nächstem Schritt erweitert. Jeder Artikel durchläuft drei Phasen:
- Optionale Selbstverankerung zur Erstellung eines strukturierten Faktenblatts
- Dynamische Gliederungserstellung mit 6–7 auf die Entität zugeschnittenen Abschnittsüberschriften
- Erstellung des vollständigen Artikels in der Freitext-Modalität, wie sie den Nutzern angezeigt wird
Die extrahierten Wikilink-Kandidaten durchlaufen eine dreistufige Bereinigungspipeline: kanonische Normalisierung (Unicode NFKC, Groß-/Kleinschreibung ignorieren), LLM-basierte Filterung benannter Entitäten zur Entfernung generischer Begriffe und embedding-basierte Deduplizierung (text-embedding-3-small, Kosinusschwellenwert 0,90) mit LLM-Entscheidung bei Grenzfällen. Redaktionelle Profile (wissenschaftlich-neutral, linksgerichtet, konservativ) werden auf Systemebene in jede Stufe der Pipeline eingebracht. Die automatische Bewertung der Faktengenauigkeit nutzt gpt-4.1-nano, um pro Artikel bis zu zehn einzelne Aussagen zu extrahieren und anhand von Wikipedia (Stufe 1) sowie kuratierten Webquellen (Stufe 2) zu überprüfen. Alle Durchläufe verwenden die Temperatur 0 mit festen Startwerten.
Ausblick
LLMpedia eröffnet mehrere Forschungsrichtungen:
- Verfolgung der Entwicklung des enzyklopädischen LLM-Wissens über verschiedene Modellgenerationen hinweg
- Analyse eingebetteter redaktioneller Verzerrungen in großem Maßstab
- Untersuchung, wie parametrisches Wissen Wikipedia ergänzen kann (~39 % der identifizierten Entitäten fehlen dort)
- Mehrsprachige Erweiterung und faktenorientierte Generierung
- Tiefgreifendere, nach Hops stratifizierte Analyse und Integration in Knowledge-Graph-Pipelines
LLMpedia bietet eine reproduzierbare, transparente Basis für den Vergleich von KI-generierten enzyklopädischen Ressourcen mit akademischen Standards der Offenheit – ein wichtiger Kontrast angesichts der Undurchsichtigkeit vergleichbarer Systeme, die derzeit öffentlich genutzt werden.
Publikationen
- Muhammed Saeed and Simon Razniewski. „LLMpedia: A Transparent Framework to Materialize an LLM’s Encyclopedic Knowledge at Scale.“ arXiv:2603.24080, 2025. https://arxiv.org/abs/2603.24080
- Yujia Hu, Tuan-Phong Nguyen, Shrestha Ghosh, and Simon Razniewski. Enabling LLM Knowledge Analysis via Extensive Materialization. ACL, 2025
Team
Teamleitung
Teammitglieder
- Muhammed Saeed



Dresden
ScaDS.AI Dresden/Leipzig
Bürogebäude Strehlener Straße
Strehlener Straße 12, 14
01069 Dresden
Center for Interdisciplinary Digital Sciences (CIDS)
ScaDS.AI Dresden/Leipzig
01062 Dresden
Leipzig
Löhrs Carré
Humboldtstraße 25, Uferstr. 11
04105 Leipzig
Data Science Center ScaDS.AI Leipzig
Internes Postfach: 322001
04081 Leipzig
Copyright 2026 © SCADS.AI Dresden/Leipzig – All rights reserved.