LLM4Edu: Lernen großer Sprachmodelle auf Graphen für den Bildungsbereich
Projekttitel: LLM4Edu: Lernen großer Sprachmodelle für Graphen für den Bildungsbereich
Projektdauer: 01.01.2025 – 31.05.2026
Forschungsbereich: Sprachverständnis, große Sprachmodelle, Verarbeitung natürlicher Sprache
Große Sprachmodelle (LLMs) haben bemerkenswerte Fähigkeiten im Bereich des kontextbezogenen Lernens (ICL) gezeigt, sowohl mit als auch ohne Trainingsdaten. Sie können beispielsweise die menschliche Sprache verstehen und allgemeine Fragen beantworten. Für ihre Anpassungsfähigkeit ist die Feinabstimmung dieser Modelle für bestimmte Aufgaben jedoch von entscheidender Bedeutung, insbesondere im Bildungsbereich. Dort haben sie das Potenzial, Lernumgebungen zu revolutionieren und stellen eine Möglichkeit dar, tiefgreifende gesellschaftliche Auswirkungen zu haben. In Zusammenarbeit mit Macmillan Learning zielt das Projekt LLM4Edu darauf ab, KI-Tools der nächsten Generation zu entwickeln, die speziell auf Bildungsanwendungen zugeschnitten sind. Mithilfe graphenbasierter Methoden extrahieren wir aussagekräftige Datensätze aus unstrukturierten Benutzerdaten und ermöglichen so die Entwicklung parameter-effizienter Feinabstimmungsmethoden, die insbesondere für Bildungskontexte geeignet sind.
Herkömmliche Feinabstimmungsmethoden stellen oft erhebliche Anforderungen an die Rechenleistung. Mit zunehmender Modellgröße wird es immer schwieriger, alle Parameter realistisch fein abzustimmen. Es wurden verschiedene parameter-effiziente Feinabstimmungsmethoden (PEFT) für LLMs eingeführt, darunter Adapter, Prefix-Tuning, Prompt-Tuning und LoRA. Diese Methoden reduzieren zwar die Trainingskosten, jedoch fehlt ihnen oft ein umfassendes Verständnis der zugrunde liegenden Mechanismen. Das führt zu einem Mangel an interpretierbaren PEFT-Ansätzen.
In diesem Projekt schlagen wir einen neuartigen Benchmark vor: Wir erstellen einen graphenbasierten Datensatz, der speziell auf den Einsatz im personalisierten Bildungsbereich zugeschnitten ist. Darüber hinaus entwickeln wir eine interpretierbare PEFT-Methode, die Graph Neural Networks (GNNs) nutzt. Diese Methode zielt nicht nur darauf ab, das Trainingsbudget zu reduzieren, sondern auch ein intuitives Verständnis der beteiligten Funktionsmechanismen zu vermitteln. Zudem werden wir unstrukturierte Daten von Macmillan Learning analysieren, um aussagekräftige Informationen zu extrahieren und einen strukturierten Datensatz zu erstellen, auf den graphenbasierte Methoden angewendet werden können. Mithilfe dieses Datensatzes werden wir die potenziellen Anwendungen von Daten im Bildungskontext untersuchen und so personalisiertere, reaktionsschnellere und effektivere Lernerfahrungen ermöglichen.
Ziele
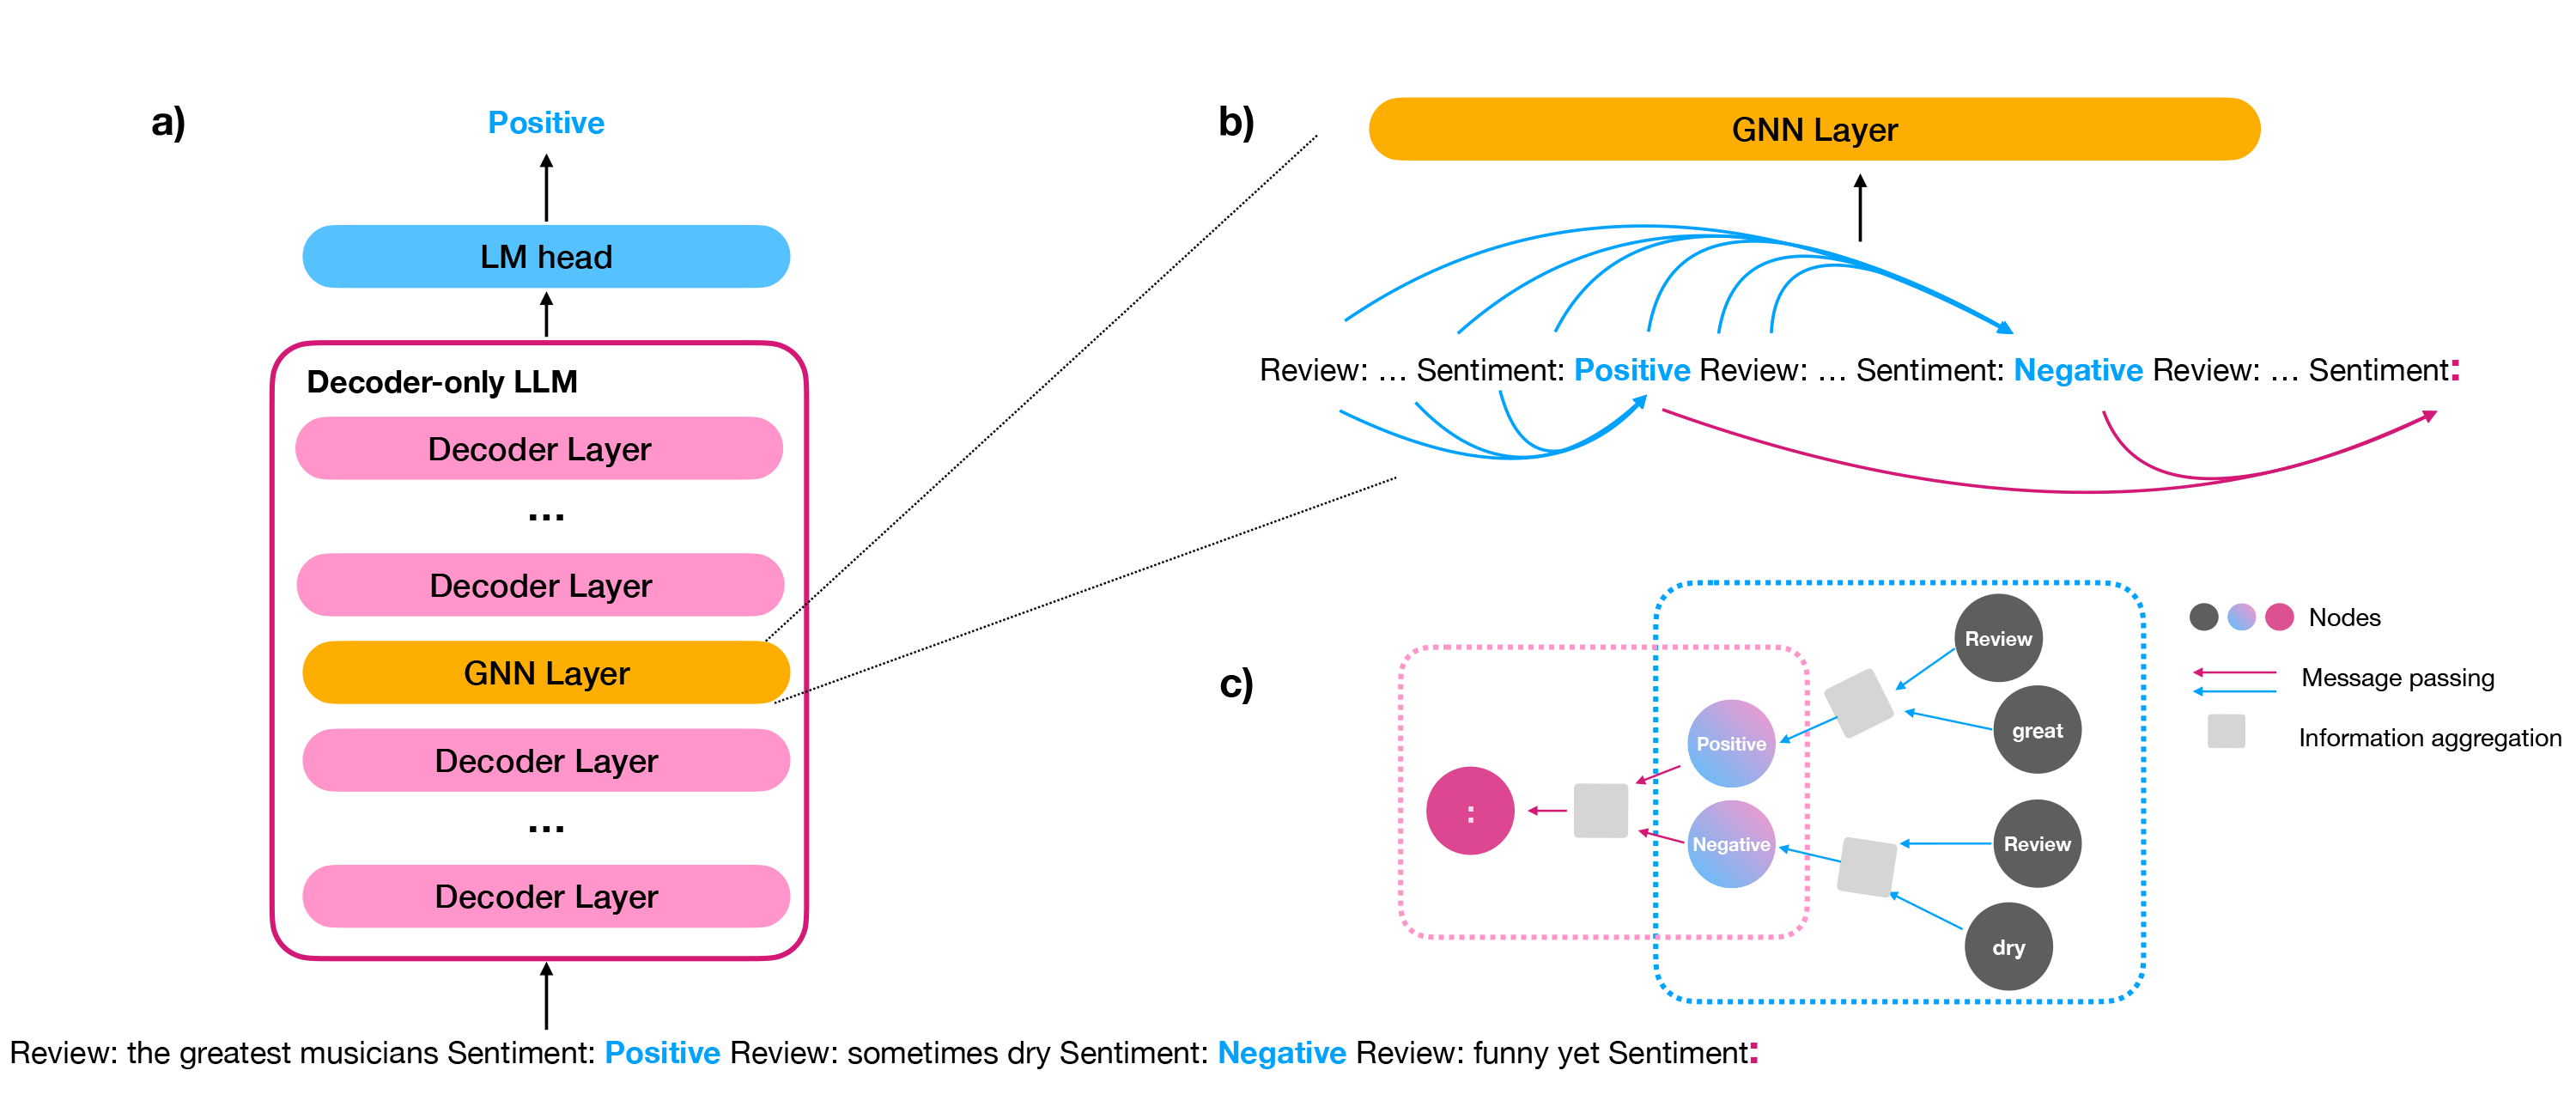
Das Hauptziel des Projekts besteht in der Entwicklung eines Bildungsdatensatzes sowie der Einführung einer graphbasierten PEFT-Methode, um den Feinabstimmungsprozess für LLMs zu optimieren. Dieser Ansatz nutzt Erkenntnisse aus der für ICL typischen Perspektive des Informationsflusses sowie aus den Informationsaggregationsprozessen von GNNs. Die von uns vorgeschlagene Methode zielt darauf ab, den Bedarf an Trainingsressourcen zu minimieren und gleichzeitig die Interpretierbarkeit des Feinabstimmungsprozesses zu erhöhen. Die spezifischen Ziele des Projekts lassen sich wie folgt zusammenfassen:
1. Entwicklung eines auf den Bildungsbereich zugeschnittenen Benchmark-Datensatzes, der die spezifischen Anforderungen und Nuancen von Bildungsumgebungen unterstützt. Dieser Datensatz dient als grundlegendes Werkzeug zum Testen und Verbessern von KI-Anwendungen im Bildungsbereich.
2. Entwicklung einer neuartigen PEFT-Methode, die den Trainingsressourcenbedarf von LLMs reduziert und die wichtigsten Parameter dieser Modelle hervorhebt. Diese Verbesserung erhöht die Transparenz und Interpretierbarkeit, was für Bildungsakteure entscheidend ist, um KI-Tools zu vertrauen und effektiv zu nutzen.
3. Überbrückung der Kluft zwischen LLMs und GNNs durch die Verwendung von GNNs zur Kodierung komplexer Beziehungen in LLMs, die speziell auf personalisierte Lernziele zugeschnitten sind. Diese Integration zielt darauf ab, die Stärken beider Technologien zu nutzen und so ein differenzierteres Verständnis und eine differenziertere Anwendung von KI in der personalisierten Bildung zu fördern.
Problem
Im Rahmen von LLM4Edu werden wir mehrere zentrale Forschungsfragen untersuchen, die darauf abzielen, den Einsatz von KI im Bildungsbereich zu optimieren.
- Erstellung von Datensätzen: Wie können wir aus den unstrukturierten Daten von Macmillan Learning einen bildungsspezifischen Benchmark-Datensatz effektiv entwerfen und erstellen? Mit welchen Methoden lässt sich sicherstellen, dass dieser Datensatz die Komplexität und Variabilität von Bildungsdaten erfasst?
- Modelloptimierung: Welche Komponenten in LLMs sind für Bildungsanwendungen am wichtigsten? Können wir die gewünschten Lernergebnisse erzielen, indem wir diese kritischen Parameter selektiv feinabstimmen, anstatt das gesamte Modell?
- Verbesserung der Bildung: Wie können maßgeschneiderte LLMs die digitalen Lern- und Lehrerfahrungen für Schüler und Pädagogen verbessern? Welche spezifischen Eigenschaften von LLMs können genutzt werden, um personalisierte Bildungswege zu unterstützen?
Technologie
Wir planen die Implementierung von LLM4Edu durch die Kombination der ausgereiftesten Forschung im Bereich der parametereffizienten Feinabstimmung mit neuartigen Methoden aus der Graphperspektive. Um die wichtigsten Komponenten in LLMs hervorzuheben, lassen wir uns von den neuesten Erkenntnissen im Bereich des kontextbezogenen Lernens und der Salienzbewertung inspirieren. Dazu verknüpfen wir die wichtigsten Token im Eingabetext fest miteinander. Im Gegensatz zu früheren Methoden werden wir verschiedene Verbindungen zwischen Token untersuchen und den Funktionsmechanismus der PEFT-Methode aufklären. Durch die Integration von GNN in LLMs werden wir die Parameter der LLMs einfrieren und nur die Parameter der GNN aktualisieren, um den Trainingsaufwand zu reduzieren.
Transferlernen bietet eine Lösung für den Wissenstransfer zwischen NLP-Aufgaben, doch der Wissenstransfer zwischen Modellen ist noch wenig erforscht. Eine kürzlich vorgeschlagene Methode kombiniert LLMs mit einer linearen Schicht. Aufbauend auf dieser Methode planen wir die Implementierung eines neuartigen Ansatzes unter Verwendung von GNNs, um Wissen von einem kleinen auf ein großes Modell zu übertragen. Zudem werden wir verschiedene GNN-Architekturen wie GCN, GAT und GraphSAGE untersuchen.
Team
Leitung
Shuzhou Yuan
Technische Universität Dresden
Professur für Skalierbare Software-architekturen für Data Analytics


Teammitglieder
Prof. Dr.-Ing. Michael Färber
Technische Universität Dresden
Professur für Skalierbare Software-Architekturen für Data Analytics
Partner



Dresden
ScaDS.AI Dresden/Leipzig
Bürogebäude Strehlener Straße
Strehlener Straße 12, 14
01069 Dresden
Center for Interdisciplinary Digital Sciences (CIDS)
ScaDS.AI Dresden/Leipzig
01062 Dresden
Leipzig
Löhrs Carré
Humboldtstraße 25, Uferstr. 11
04105 Leipzig
Data Science Center ScaDS.AI Leipzig
Internes Postfach: 322001
04081 Leipzig
Copyright 2026 © SCADS.AI Dresden/Leipzig – All rights reserved.