
GPTKB: Aufbau sehr großer Wissensdatenbanken aus Sprachmodellen
Titel: GPTKB
Projektdauer: 8/2024 – Open End
Demonstrator: https://gptkb.org
Forschungsbereich: Sprache verstehen
Im Rahmen des GPTKB-Projekts wird der Aufbau einer großen, allgemeinen Wissensdatenbank (KB) untersucht, die vollständig aus einem großen Sprachmodell (LLM) generiert wird. Dabei wird die Machbarkeit der Erstellung groß angelegter Wissensdatenbanken aus LLMs veranschaulicht und es werden zentrale Herausforderungen wie die Erkennung und Kanonisierung von Entitäten und Eigenschaften sowie die Erstellung von Taxonomien behandelt.
Ziele
Das Projekt soll zeigen, dass LLMs, insbesondere GPT-4o-mini, als brauchbare Quellen für den Aufbau großer Wissensdatenbanken dienen können und neue Einblicke in die Wissensrepräsentation von LLMs für das Natural Language Processing (NLP) bieten. Darüber hinaus werden neue Ansätze für den Aufbau von Wissensdatenbanken für allgemeine Domänen im Semantic Web untersucht.
Problem
Der Aufbau von Wissensdatenbanken (KBC) mithilfe traditioneller Methoden ist oft kostspielig, ressourcenintensiv und erfordert komplexe manuelle Prozesse. Das Projekt versucht, diese Einschränkungen zu überwinden, indem es LLMs für die Erstellung von Wissensdatenbanken nutzt. Dadurch lassen sich die Kosten und der Zeitaufwand im Vergleich zu früheren Ansätzen erheblich reduzieren.
Anwendungsbeispiel
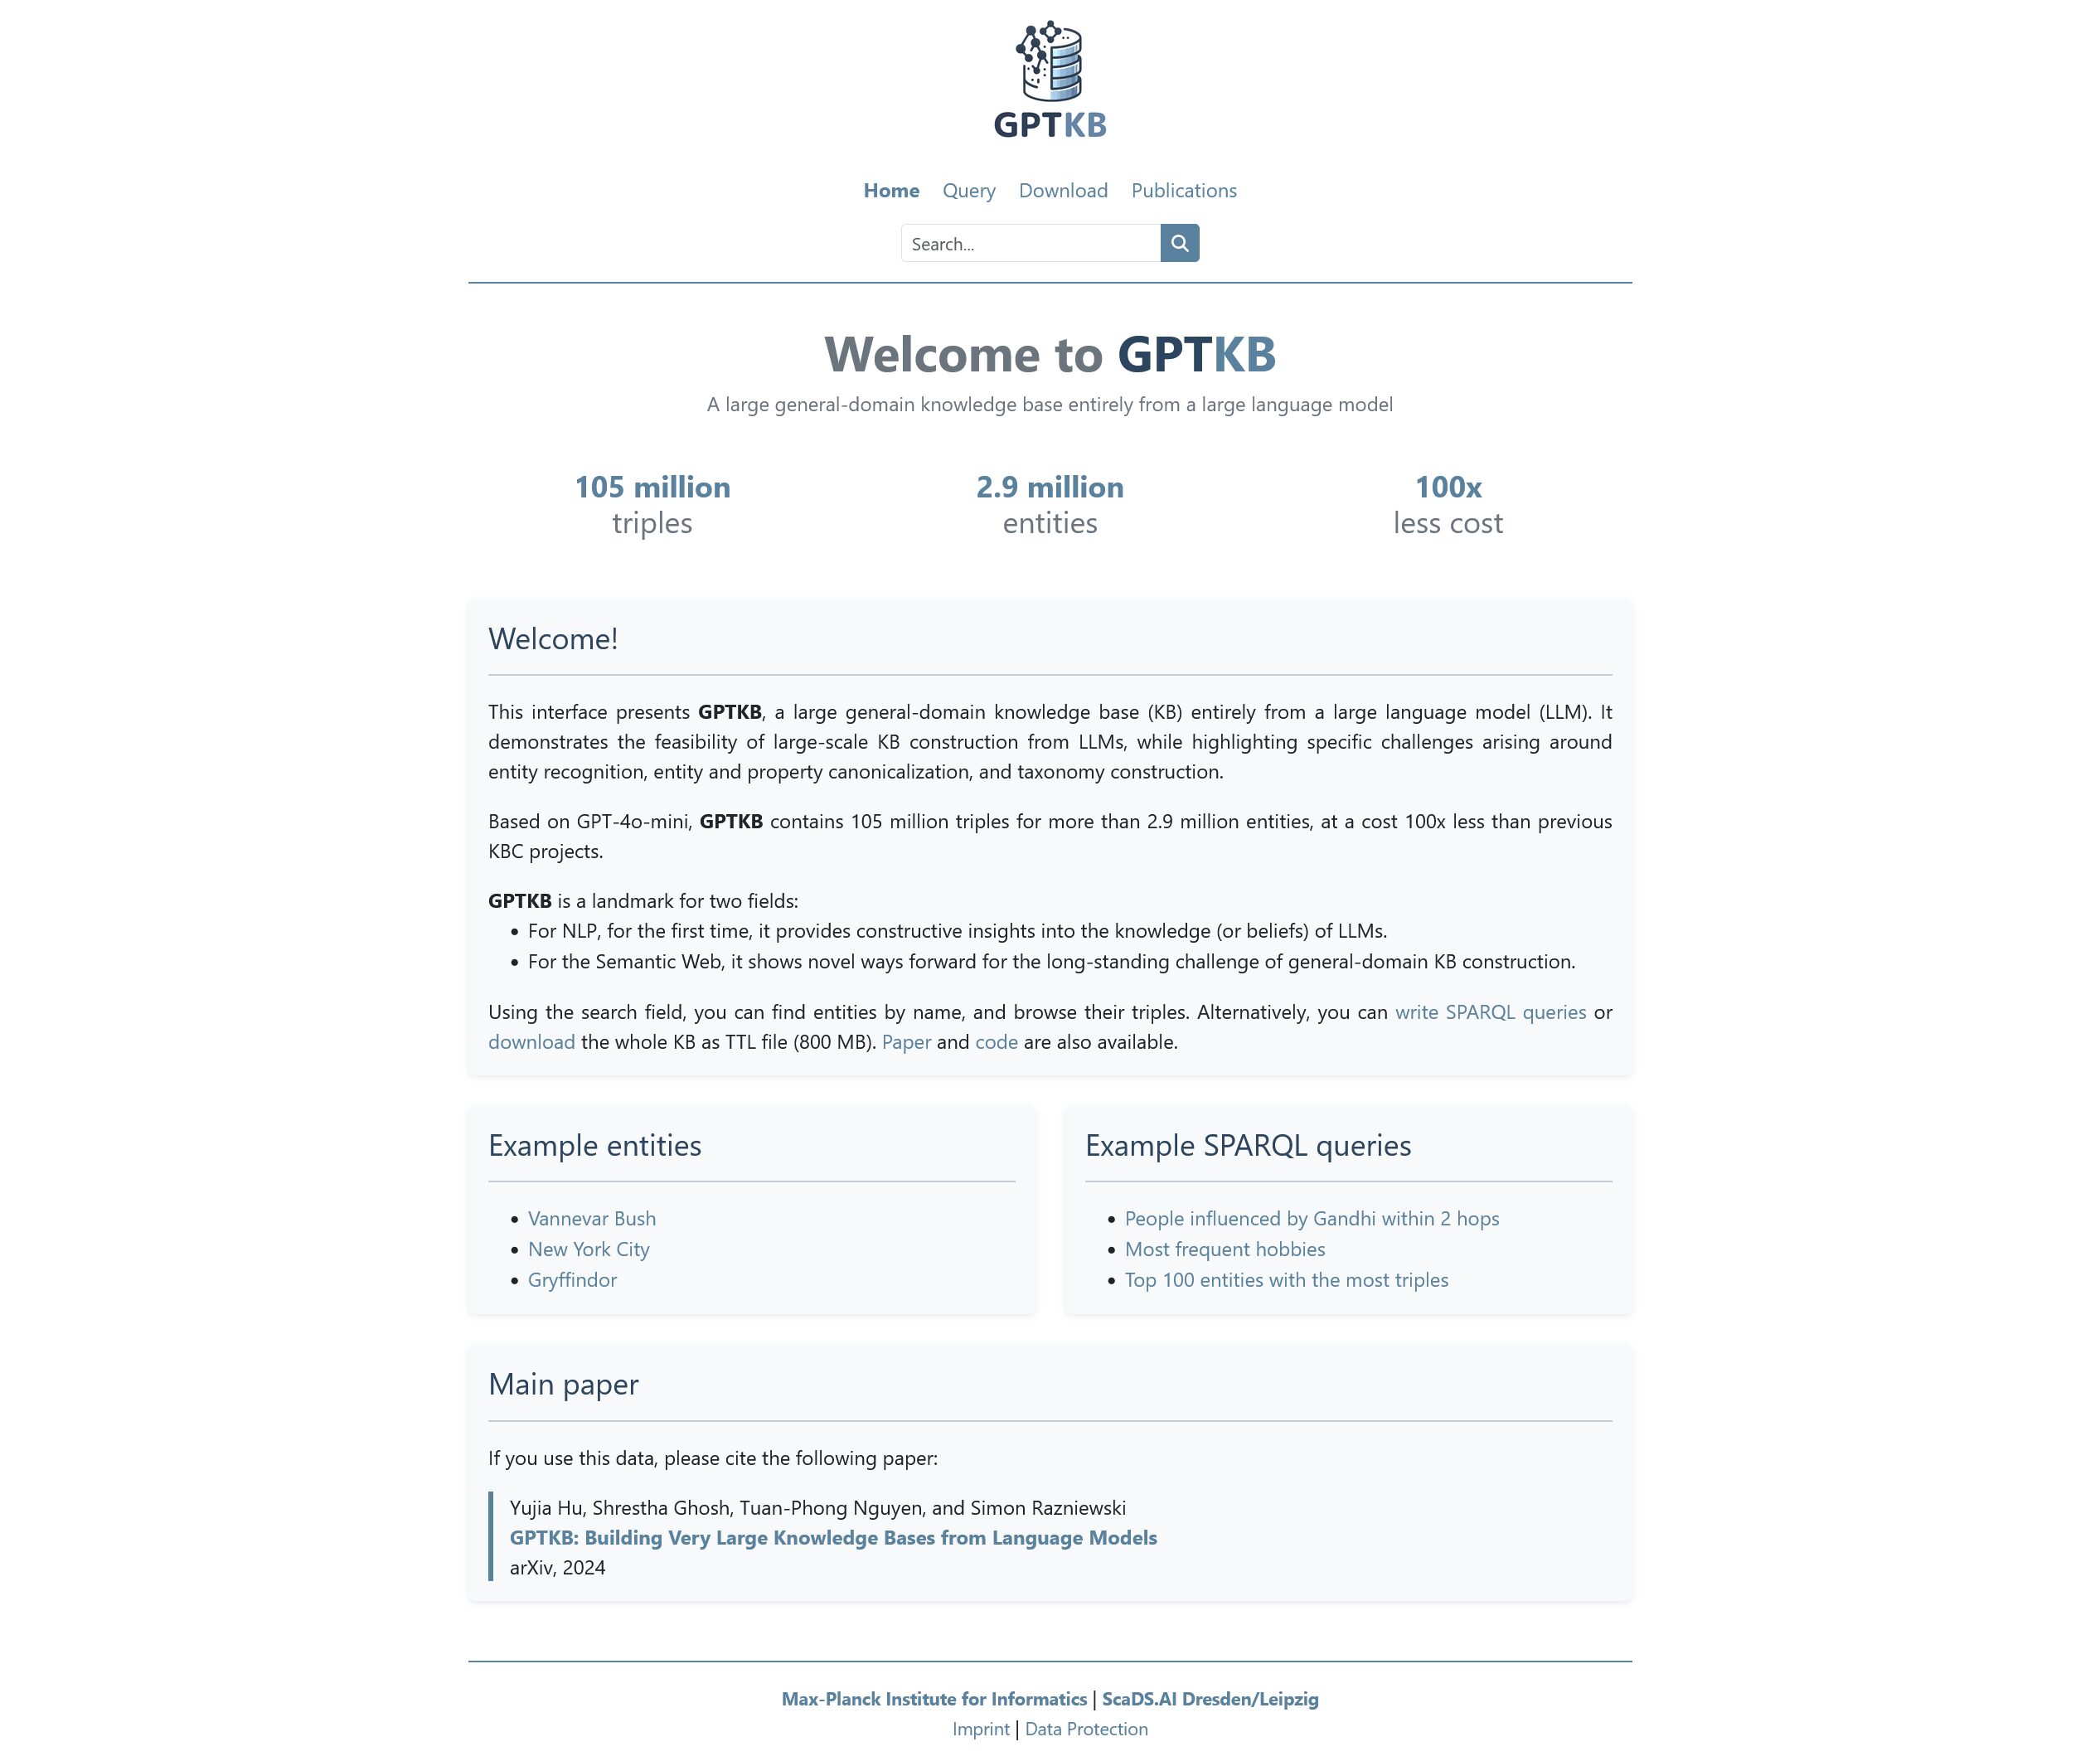
Wir haben einen Prototyp einer Wissensbasis (KB) auf Basis von GPT-4o-mini erstellt. Diese enthält mehr als 105 Millionen Tripel für 2,9 Millionen Entitäten. Über eine Webschnittstelle können Benutzer*innen nach Entitäten anhand ihres Namens suchen und die zugehörigen Tripel anzeigen lassen. Die Schnittstelle unterstützt auch komplexere Abfragen über SPARQL. Zudem kann die gesamte Wissensbasis als TTL-Datei (800 MB) heruntergeladen werden, wodurch sie für eine Vielzahl von Forschungs- und Anwendungszwecken zugänglich wird.
Technologie
Im Mittelpunkt dieses Ansatzes steht die Aufforderung, Tripel für eine bestimmte Subjektentität einzugeben. Diese Aufforderung wird rekursiv ausgeführt, um die Wissensbasis des LLMs in hochgradig parallelisierter Weise zu crawlen und so Ausführungen im Millionenbereich zu ermöglichen. Die Aufforderung selbst besteht aus zwei Komponenten: Zunächst schätzt das LLM die Anzahl der ihm bekannten Tripel für das Subjekt und erzeugt anschließend diese Anzahl an Tripeln. Die zurückgegebenen Tripel durchlaufen dann mehrere Kanonisierungsstufen, insbesondere in Bezug auf Entitäten, Beziehungen und Klassen sowie die Erstellung einer Taxonomie.
Ausblick
GPTKB setzt einen Meilenstein in der NLP- und Semantic-Web-Forschung. Die Plattform bietet ein konstruktives Verständnis von LLM-basierten Wissensstrukturen und ebnet den Weg für effizientere und skalierbarere Techniken zur Konstruktion von KBs. Mögliche zukünftige Entwicklungen könnten die Verbesserung der Entitätsgenauigkeit sowie die Erstellung von Taxonomien in von LLMs erstellten KBs umfassen.
Publikationen
- Yujia Hu, Shrestha Ghosh, Tuan-Phong Nguyen, Simon Razniewski (2024). GPTKB: Building Very Large Knowledge Bases from Language Models. Arxiv: http://arxiv.org/abs/2411.04920
Team
Leitung
Teammitglieder
- Yujia Hu
- Akash Kumar Gautam
- Shrestha Ghosh (Universität Tübingen)
- Tuan-Phong Nguyen (MPI für Informatik Saarbrücken)
Partner
FAQ
GPTKB ist eine groß angelegte Wissensdatenbank für allgemeine Themenbereiche, die vollständig auf Daten basiert, die von einem großen Sprachmodell generiert wurden. Unser Team wurde von dem umfangreichen Wissen inspiriert, über das LLMs verfügen, wie es auch von anderen Forschern wie (Petroni et al., 2019) beobachtet wurde. Wir wollten herausfinden, ob LLMs als kostengünstige Quelle für den Aufbau einer umfassenden Wissensdatenbank genutzt werden können, die ein breites Spektrum an allgemeinen Wissensbereichen abdeckt.
Traditionelle Wissensdatenbanken wie Wikidata oder DBpedia werden durch manuelle Kuratierung oder Extraktion aus strukturierten Quellen aufgebaut. Dieser Prozess ist ressourcenintensiv und begrenzt gleichzeitig den Umfang der Datenbanken. GPTKB wurde hingegen ausschließlich aus einem LLM generiert – und das zu einem Bruchteil der Kosten: Die Ausgaben waren etwa 100-mal geringer als bei früheren Projekten zum Aufbau von Wissensdatenbanken. Die Datenbank enthält über 105 Millionen Tripel zu 2,9 Millionen Entitäten und deckt damit das allgemeine Wissen ab, das in den Vorab-Trainingskorpora des LLM enthalten ist. Dies erfolgt auf eine automatisiertere und skalierbarere Weise als mit herkömmlichen Methoden.
Ein wesentlicher Vorteil ist die Kosten- und Zeiteffizienz. Da LLMs bereits mit riesigen Informationsmengen trainiert sind, geht es bei der Erstellung einer Wissensdatenbank eher darum, das LLM anzuleiten, Wissen systematisch zu extrahieren. Ein weiterer Vorteil dieses Ansatzes besteht darin, dass er neue Einblicke in das „Wissen” oder die Überzeugungen von LLMs bietet. Dieser Bereich hat in letzter Zeit als LLMology an Popularität gewonnen. GPTKB gibt uns Aufschluss über die Art und Weise, wie das LLM Wissen organisiert und verknüpft. Dies ist für die NLP-Forschung von großem Wert. Für das Semantic Web eröffnet es zudem einen neuen Ansatz zur Bewältigung der Herausforderung des Aufbaus breit gefächerter, domänenübergreifender Wissensdatenbanken.
Die Qualität der resultierenden Wissensbasis, insbesondere ihre Genauigkeit, entspricht bei Weitem nicht den Anforderungen nachgelagerter Anwendungsfälle und bestehenden Projekten. Insbesondere generiert das LLM viele falsche Fakten und noch mehr Fakten, die sich überhaupt nicht (online) verifizieren lassen. So behauptet es beispielsweise, dass im Dresdner Zoo afrikanische Elefanten (richtig) und sibirische Tiger (falsch) leben. Für Karl May wird ein Einfluss von Mark Twain behauptet, den wir mit Online-Recherchen weder bestätigen noch widerlegen konnten. Meiner Meinung nach ist noch wesentlich mehr Arbeit erforderlich, um das resultierende Wissen zu filtern und zu konsolidieren.
GPTKB findet Anwendung in der NLP-Forschung, wo es Einblicke in die Wissensorganisation von LLM liefert und als Ressource für die Untersuchung der Wissensgewinnung dieser Modelle dient. In der Semantic-Web-Community könnte es Projekte unterstützen, die umfangreiche Daten aus allgemeinen Bereichen benötigen. GPTKB ist außerdem so konzipiert, dass es für jedermann zugänglich ist: Jeder kann nach Entitäten suchen, Informationen durchsuchen und sogar SPARQL-Abfragen ausführen, um bestimmte Beziehungen zu untersuchen.
Wir sind überrascht, wie viel Wissen (oder Überzeugungen) ein LLM relativ moderater Größe bereits besitzt. GPT-4o-Mini verfügt schätzungsweise über rund 8 Milliarden Parameter, lieferte uns jedoch 105 Millionen Tripel, was 76 Parameter pro Tripel entspricht. Überrascht hat uns auch die thematische Verteilung: Wir haben viele Tripel zu Patenten und historischen Persönlichkeiten erhalten, zu aktuellen Wissenschaftlern hingegen weniger.
Es ist unter gptkb.org öffentlich zugänglich. Benutzer können nach bestimmten Entitäten suchen, Beziehungen anzeigen oder die gesamte Wissensdatenbank im TTL-Format herunterladen. Wir haben auch die Veröffentlichung und den Code für diejenigen verfügbar gemacht, die sich eingehender mit der Forschung befassen und möglicherweise zu zukünftigen Entwicklungen beitragen möchten.



Dresden
ScaDS.AI Dresden/Leipzig
Bürogebäude Strehlener Straße
Strehlener Straße 12, 14
01069 Dresden
Center for Interdisciplinary Digital Sciences (CIDS)
ScaDS.AI Dresden/Leipzig
01062 Dresden
Leipzig
Löhrs Carré
Humboldtstraße 25, Uferstr. 11
04105 Leipzig
Data Science Center ScaDS.AI Leipzig
Internes Postfach: 322001
04081 Leipzig
Copyright 2026 © SCADS.AI Dresden/Leipzig – All rights reserved.